


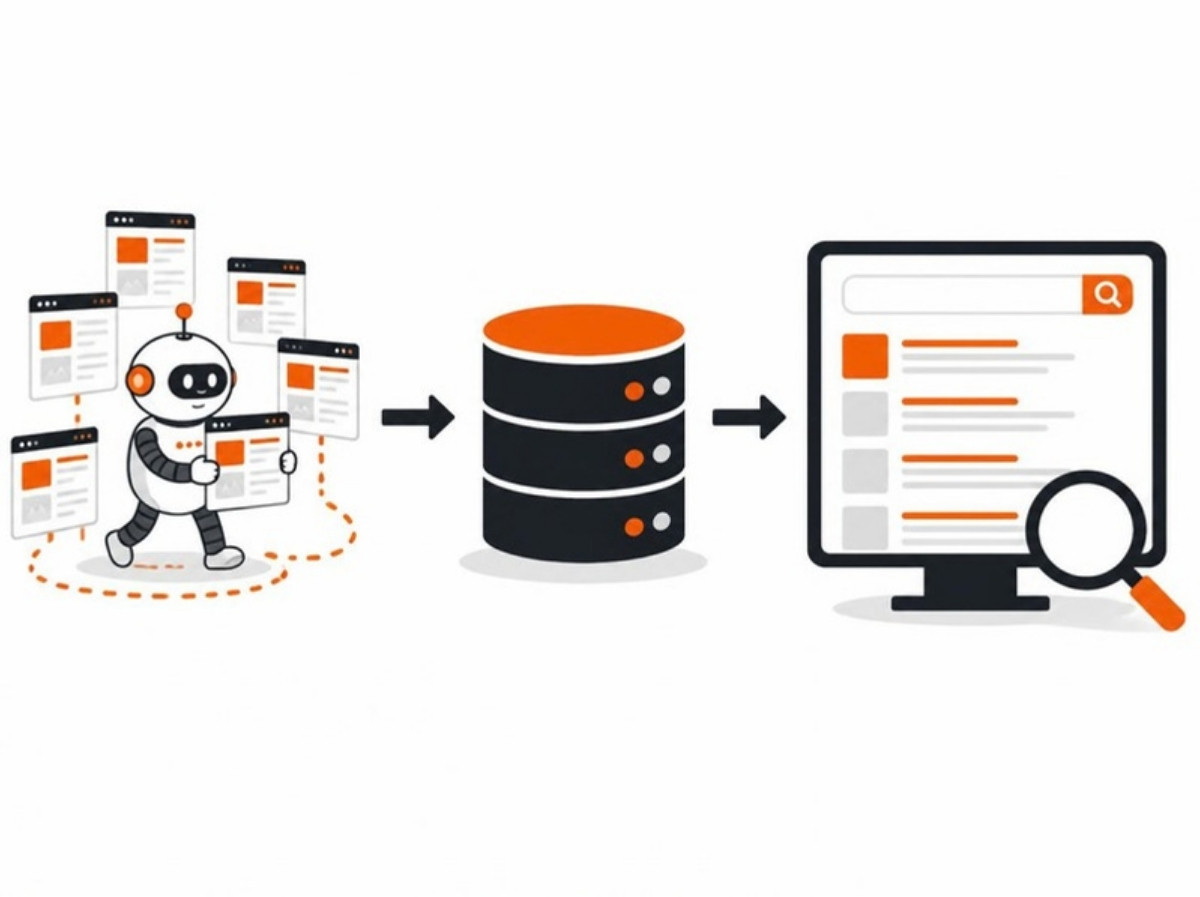
AIクローラーとは、ChatGPTやClaudeなどの生成AIを提供する会社が、AIの学習やAI検索の回答づくりのために、Webページを自動で読みに来るプログラムです。
止めるか許すかは、学習用とAI検索用を分けて決めるのが、集客と権利を両立させる近道です。本記事では、主なクローラーの名前と役割、robots.txtでの遮断の書き方と確かめ方を解説します。
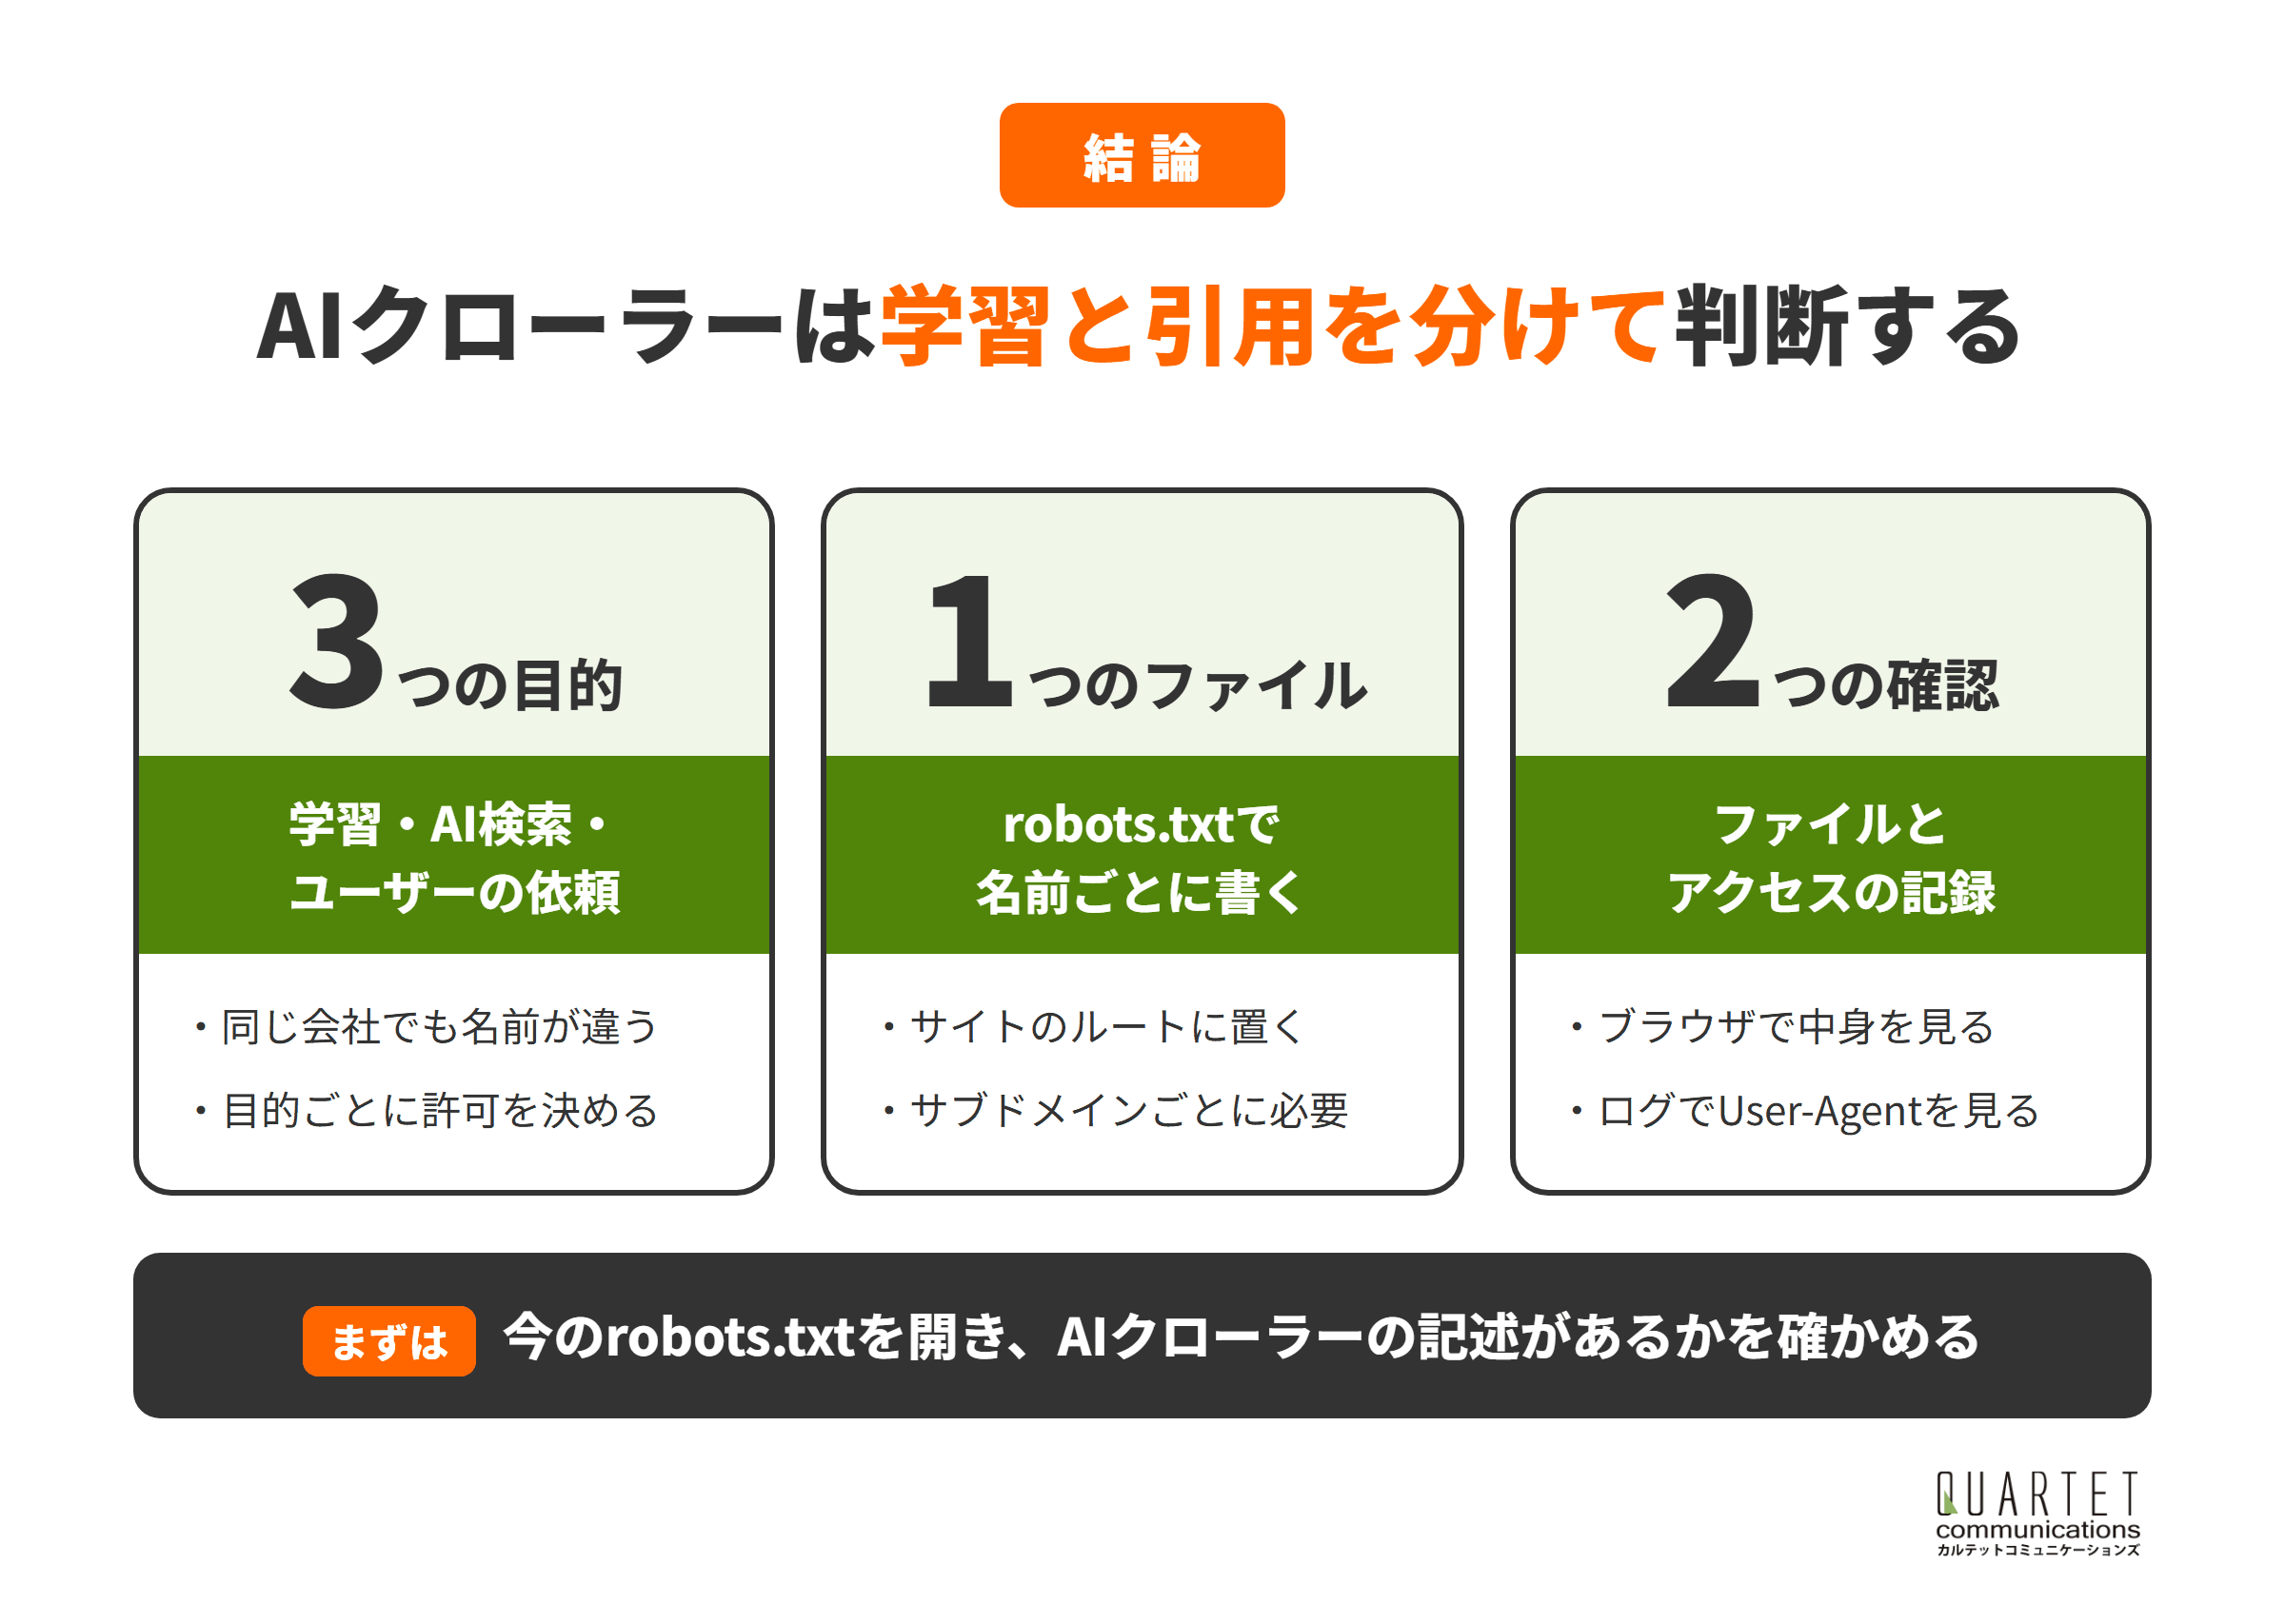
この記事でわかること
- AIクローラーの3つの目的と、検索エンジンのクローラーとの違い
- GPTBot・ClaudeBotなど、主なAIクローラーの名前と役割
- 止めるか許すかを、サイトの目的で決める考え方
- robots.txtでAIクローラーを遮断する書き方の例
- 設定のあとに確かめることと、よくある誤解
なお、AIクローラーの扱いやAI検索での見え方に不安がある方は、カルテットコミュニケーションズのAIO・LLMOコンサルティングの無料相談もご活用ください。
今のrobots.txtとアクセスの状況を拝見し、集客と権利のバランスを踏まえた設定の方針を一緒に整理します。
カルテットのAIO(AI検索対策)コンサルティング
ChatGPT・Gemini・GoogleのAIによる概要で、自社が引用・推奨される状態をつくる支援です。今の見え方の診断から、コンテンツや会社情報・構造化データの整備、引用状況の計測までまとめて対応します。
AIクローラーとは?生成AIの会社がWebページを読みに来る仕組み
この章でわかること
- 定義①|目的は「学習」「AI検索」「ユーザーの依頼」の3つ
- 定義②|検索エンジンのクローラーとの違い
- 定義③|robots.txtは、守ってもらう前提のルール
- 定義④|止めるかどうかは、目的ごとに分けて決める
インターネット上には、人ではなくプログラムが自動でWebページを読みに来るアクセスがたくさんあります。
そのうち、生成AIを提供する会社が動かしているものを、一般にAIクローラーと呼びます。
定義①|目的は「学習」「AI検索」「ユーザーの依頼」の3つ
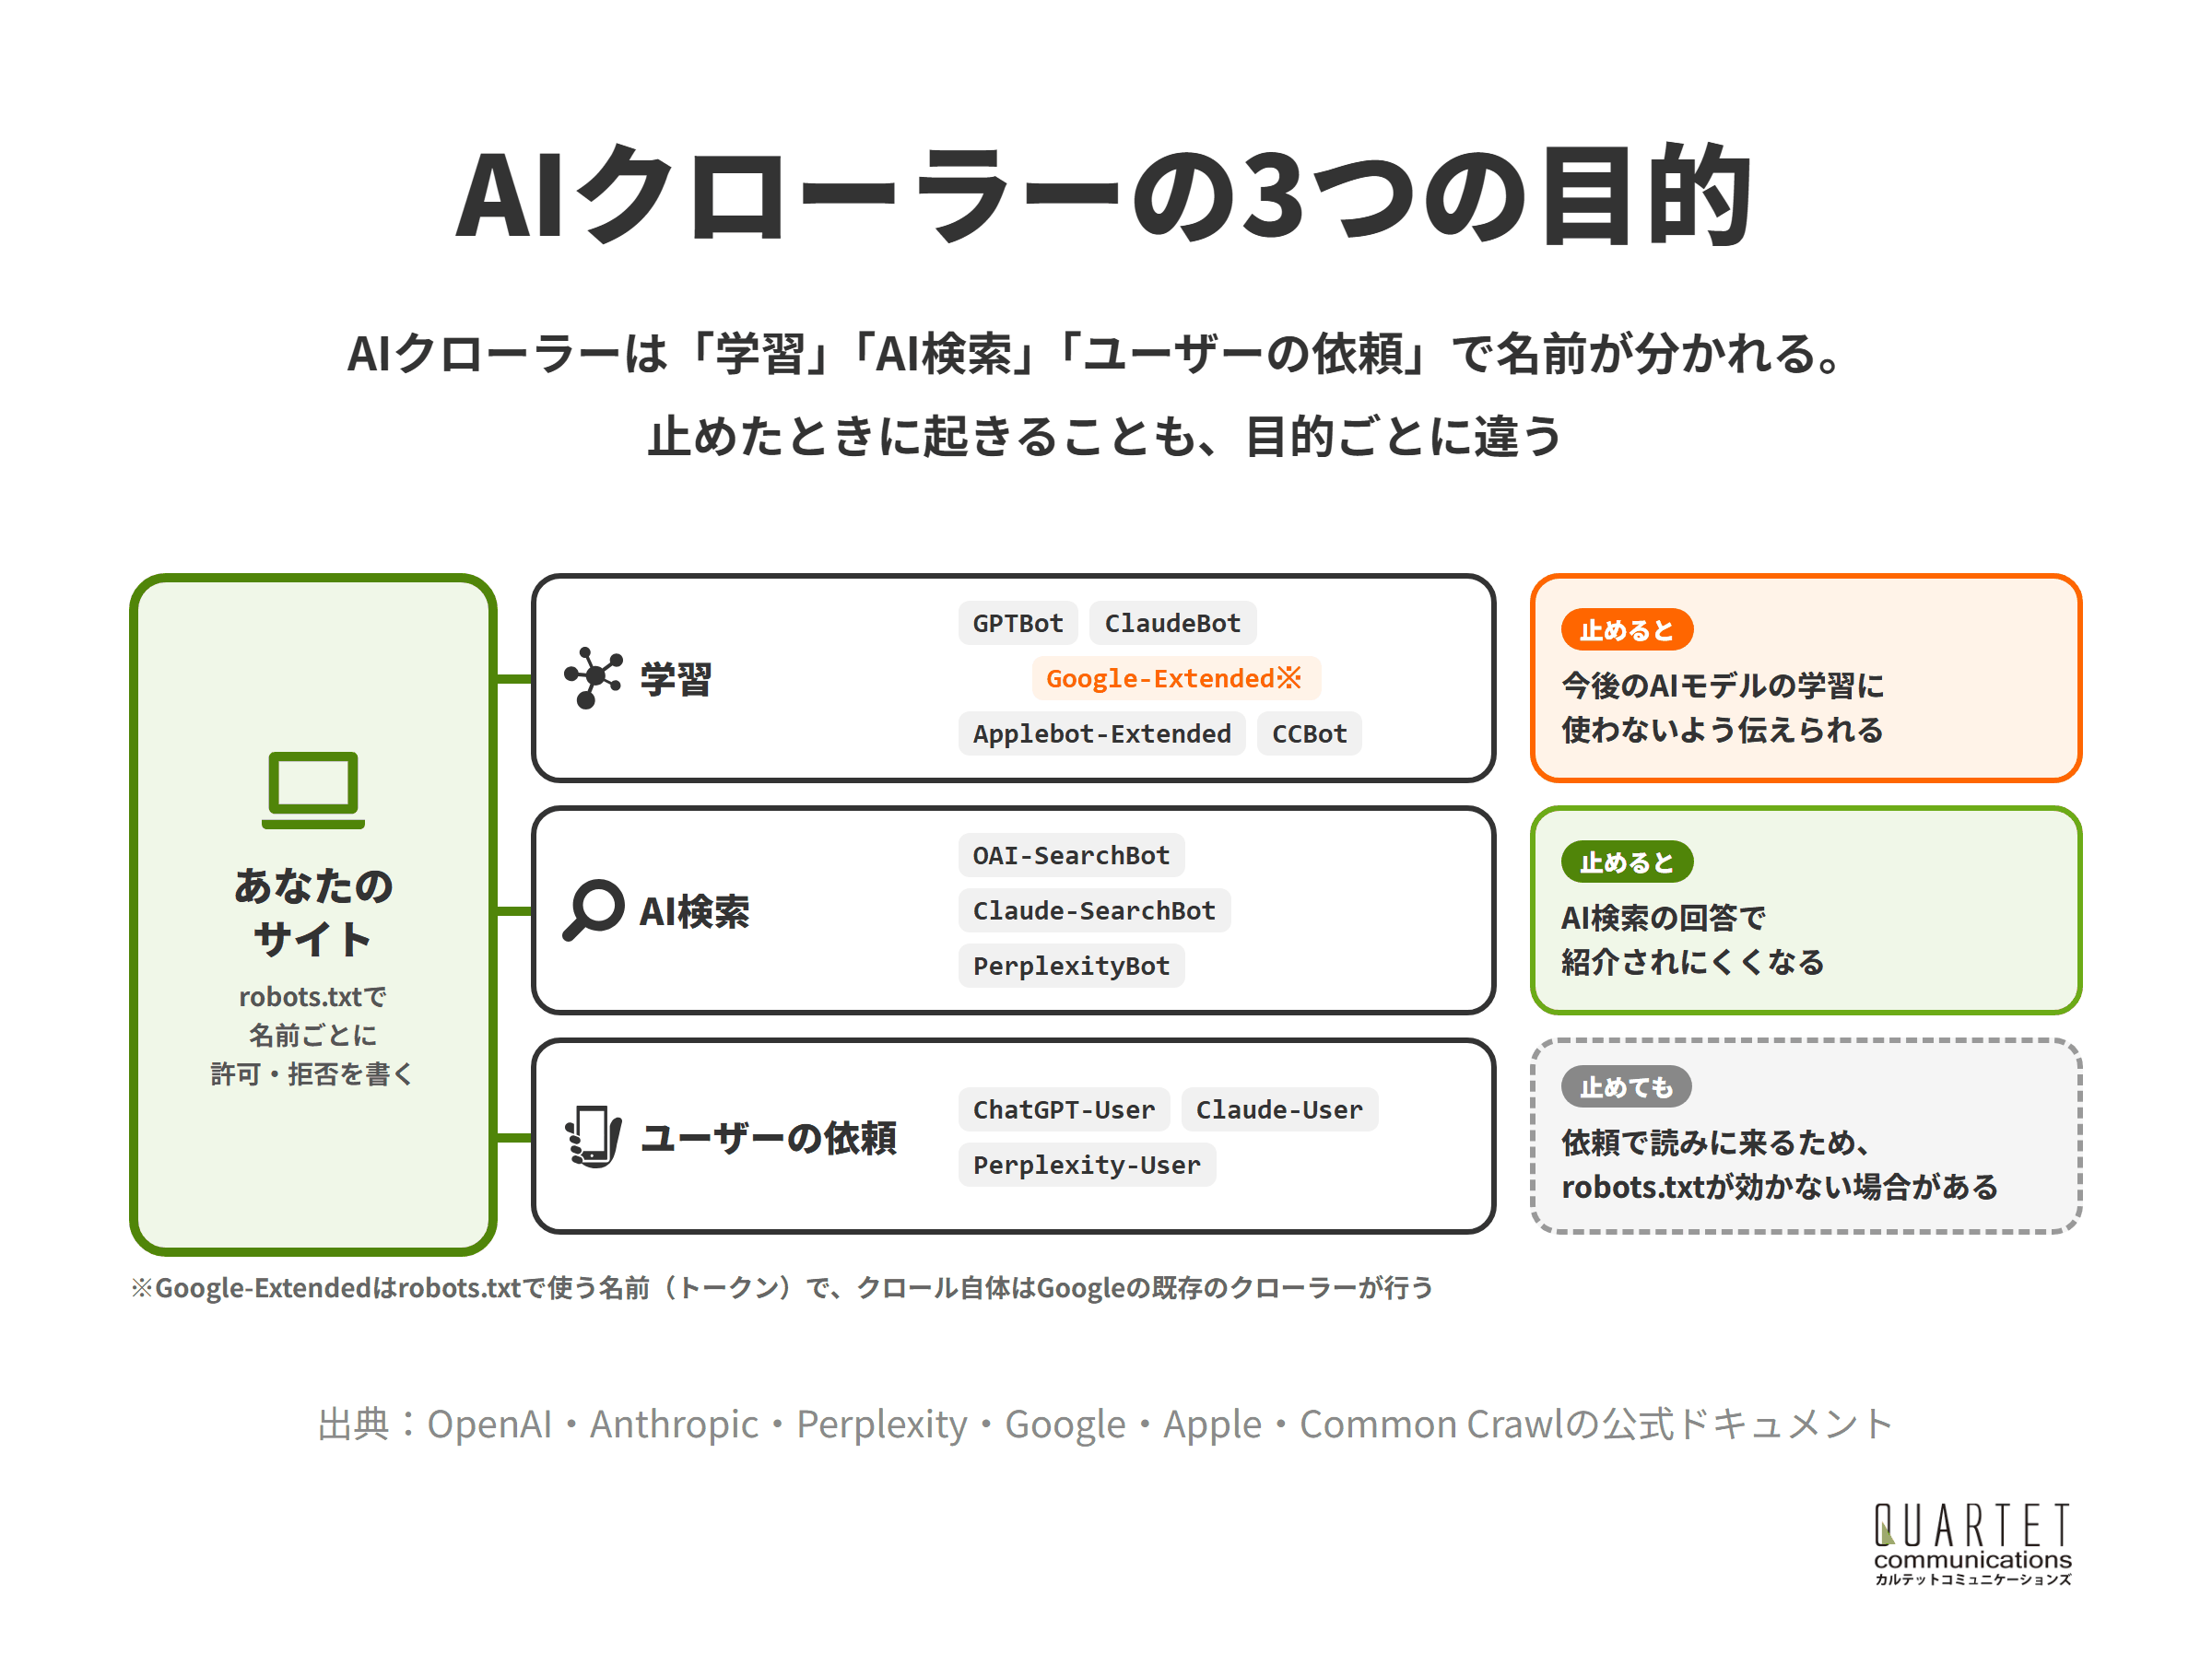
AIクローラーの目的は、大きく3つに分けられます。
1つ目はAIモデルの学習のためにページを集めるもの、2つ目はChatGPTの検索やPerplexityのようなAI検索の回答でサイトを紹介するためのもの、3つ目はユーザーがAIに質問したときに、その場でページを読みに行くものです。
同じ会社でも、目的ごとにクローラーの名前(ユーザーエージェント)を分けている場合が多く、名前によって止めたときに起きることが違います。
AIクローラーは、名前よりもまず「何のために来ているか」で見分けましょう。
定義②|検索エンジンのクローラーとの違い
Googlebotのような検索エンジンのクローラーは、検索結果にページを載せるために、サイトを巡回して内容を集めます。
AIクローラーのうちAI検索用のものはこれに近い役割ですが、学習用のものは、集めた内容をAIモデルの学習に使う点が違います。
また、Googleの検索のAI機能のように、検索エンジンのクローラーが集めた内容がAIの回答に使われる場合もあり、AIクローラーだけを見ていても全体はつかめません。
検索とAIの関係は、SEO・AEO/GEO・AIO・LLMOの違いでも整理しています。
AIでの見え方は、AIクローラーと検索エンジンのクローラーの両方を見て考えましょう。
定義③|robots.txtは、守ってもらう前提のルール
AIクローラーの許可や拒否は、サイトのルートに置くrobots.txtというファイルで、クローラーの名前ごとに書くのが基本です。
ただし、robots.txtは相手に守ってもらうことを前提にしたルールで、アクセスそのものを止める鍵ではありません。
サイトに対するクローラーの動作に対して、robots.txt ファイルの指示を強制適用することはできません。指示に従うかどうかはクローラー次第です。
引用元:Google検索セントラル「robots.txt の概要とガイド」
大手の会社のクローラーは公式にrobots.txtに従うと説明していますが、名前を偽るアクセスや、ルールを守らないボットには効きません。
robots.txtは「お願い」であり、守りたい情報はログインなど別の方法で守りましょう。
定義④|止めるかどうかは、目的ごとに分けて決める
AIクローラーの話になると、「全部止めるべきか、全部許すべきか」の二択で考えがちです。
しかし、学習用を止めてもAI検索での紹介は続けられ、反対にAI検索用を止めると、ChatGPTなどの回答で自社が紹介されにくくなります。
自社のサイトが何のためにあるのか、集客なのか、記事そのものが商品なのかによって、止めるべき相手は変わります。
止めるかどうかは、学習用・AI検索用・ユーザーの依頼用を分けて決めましょう。
主なAIクローラーの名前と役割(GPTBot・ClaudeBotなど)
この章でわかること
- 会社①|OpenAIは「学習」「検索」「依頼」で名前を分けている
- 会社②|Anthropicも3つのボットを使い分けている
- 会社③|Googleは、Googlebotとは別にGoogle-Extendedで学習を管理する
- 会社④|Perplexityは、検索用とユーザーの依頼用の2つ
- 会社⑤|Apple・Common Crawlなど、そのほかのクローラー
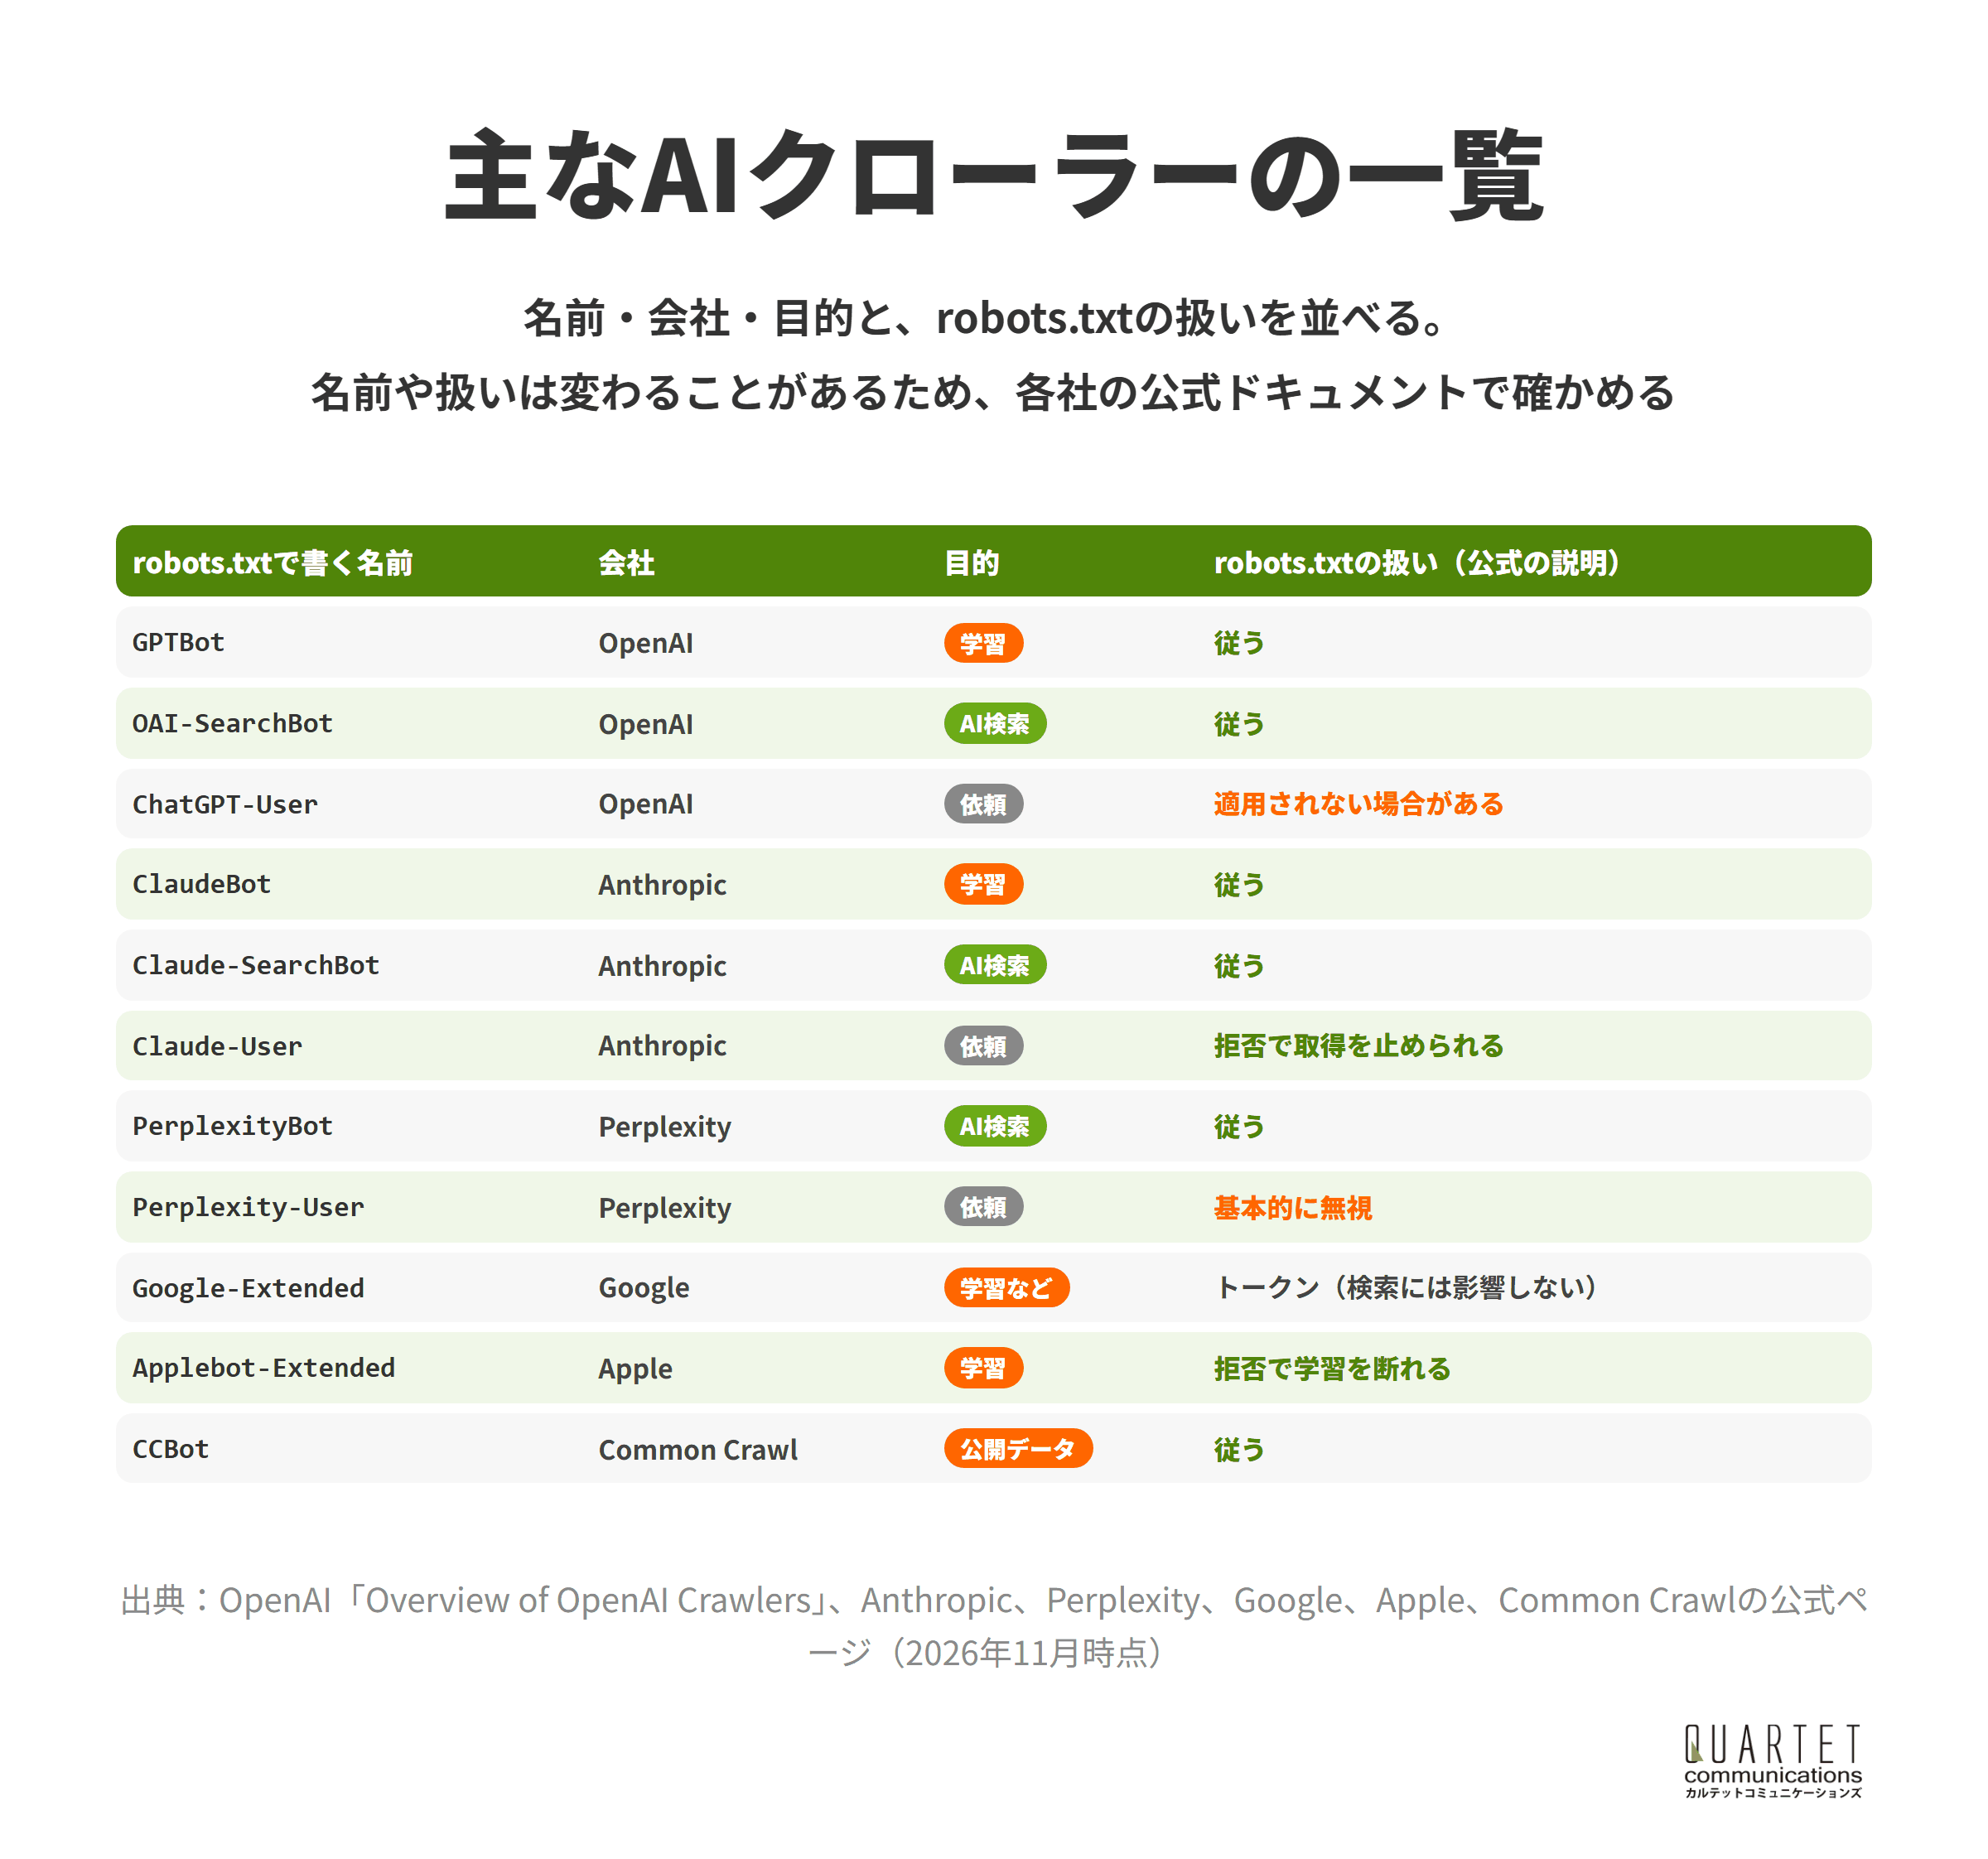
主なAIクローラーの名前と役割は、各社が公式のドキュメントで公開しています。
名前や扱いは更新されることがあるため、設定する前に、各社の最新の公式ページを確かめておきます。
会社①|OpenAIは「学習」「検索」「依頼」で名前を分けている
ChatGPTを提供するOpenAIは、学習用のGPTBot、ChatGPTの検索用のOAI-SearchBot、ユーザーの操作で読みに行くChatGPT-Userを分けて公開しています。
Disallowing GPTBot indicates a site’s content should not be used in training generative AI foundation models.
引用元:OpenAI「Overview of OpenAI Crawlers」
(GPTBotを拒否すると、サイトのコンテンツを生成AIの基盤モデルの学習に使わないよう示すことになります。)
一方で、OAI-SearchBotはChatGPTの検索でサイトを紹介するためのもので、GPTBotとは別に許可と拒否を決められます。
ChatGPT-Userはユーザーの操作で動くため、robots.txtのルールが適用されない場合があるとされています。
OpenAIでは、GPTBotとOAI-SearchBotを分けて、許可と拒否を決めましょう。
会社②|Anthropicも3つのボットを使い分けている
Claudeを提供するAnthropicは、学習用のClaudeBot、検索の質を高めるためのClaude-SearchBot、ユーザーの質問で読みに行くClaude-Userの3つを公開しています。
When a site restricts ClaudeBot access, it signals that the site’s future materials should be excluded from our AI model training datasets.
引用元:Anthropic「Does Anthropic crawl data from the web, and how can site owners block the crawler?」
(ClaudeBotのアクセスを制限すると、そのサイトの今後の資料をAIモデルの学習データから除外するよう示すことになります。)
Anthropicは、Claude-UserやClaude-SearchBotを止めると、ユーザーの検索での見え方が下がる可能性があることも説明しています。
また、サブドメインごとにrobots.txtの設定が必要なことや、IPアドレスでのブロックはオプトアウトの方法として正しく働かない場合があることも書かれています。
Anthropicの学習を断るなら、ClaudeBotをサブドメインごとに拒否しましょう。
会社③|Googleは、Googlebotとは別にGoogle-Extendedで学習を管理する
Googleの場合、検索のためのクロールはGooglebotが行い、AIの学習などへの利用はGoogle-Extendedという名前で管理します。
Google-Extendedは独立したクローラーではなく、robots.txtで使う名前(トークン)で、Geminiのモデルの学習や、Geminiアプリなどでの検索を使った回答(グラウンディング)に自社のコンテンツを使うかどうかを決めるためのものです。
Google-Extended が Google 検索でのサイトの登録に影響したり、Google 検索でのランキング シグナルとして使用されたりすることはありません。
引用元:Google「Google の一般的なクローラー」
Google-Extendedを止めても、Googleの検索順位や検索への登録には影響しません。
会社④|Perplexityは、検索用とユーザーの依頼用の2つ
AI検索のPerplexityは、検索結果でサイトを紹介するためのPerplexityBotと、ユーザーの質問に答えるために読みに行くPerplexity-Userを公開しています。
公式の説明では、PerplexityBotはAIの基盤モデルの学習には使われないとされ、検索結果に載るために許可することが勧められています。
Perplexity-Userはユーザーが依頼した取得のため、基本的にrobots.txtのルールを無視するとされています。
Perplexityで紹介されたいなら、PerplexityBotは止めないようにしましょう。
会社⑤|Apple・Common Crawlなど、そのほかのクローラー
Appleは、Applebotが集めたデータをAppleの生成AIの基盤モデルの学習にも使う場合があり、robots.txtでApplebot-Extendedを拒否すると、学習への利用を断れると説明しています。
非営利団体のCommon Crawlが動かすCCBotは、集めたWebのデータを、誰でも使える公開のデータとして提供しています。
このほかにも、さまざまな会社がAIのためのクローラーを動かしているため、アクセスの記録で実際に来ている名前を確かめておくと安心です。
一覧にない名前は、アクセスの記録で実際に来ているかを確かめてから判断しましょう。
カルテットのAIO(AI検索対策)コンサルティング
ChatGPT・Gemini・GoogleのAIによる概要で、自社が引用・推奨される状態をつくる支援です。今の見え方の診断から、コンテンツや会社情報・構造化データの整備、引用状況の計測までまとめて対応します。
AIクローラーを止める前に考えたい、サイトの目的と線引き
この章でわかること
- 考え方①|集客したいサイトは、AI検索用のクローラーを止めない
- 考え方②|学習に使われたくないなら、学習用だけを止める
- 考え方③|会員向けや有料の情報は、ログインで守る
- 考え方④|サーバーが重いときは、まずアクセスの記録を見る
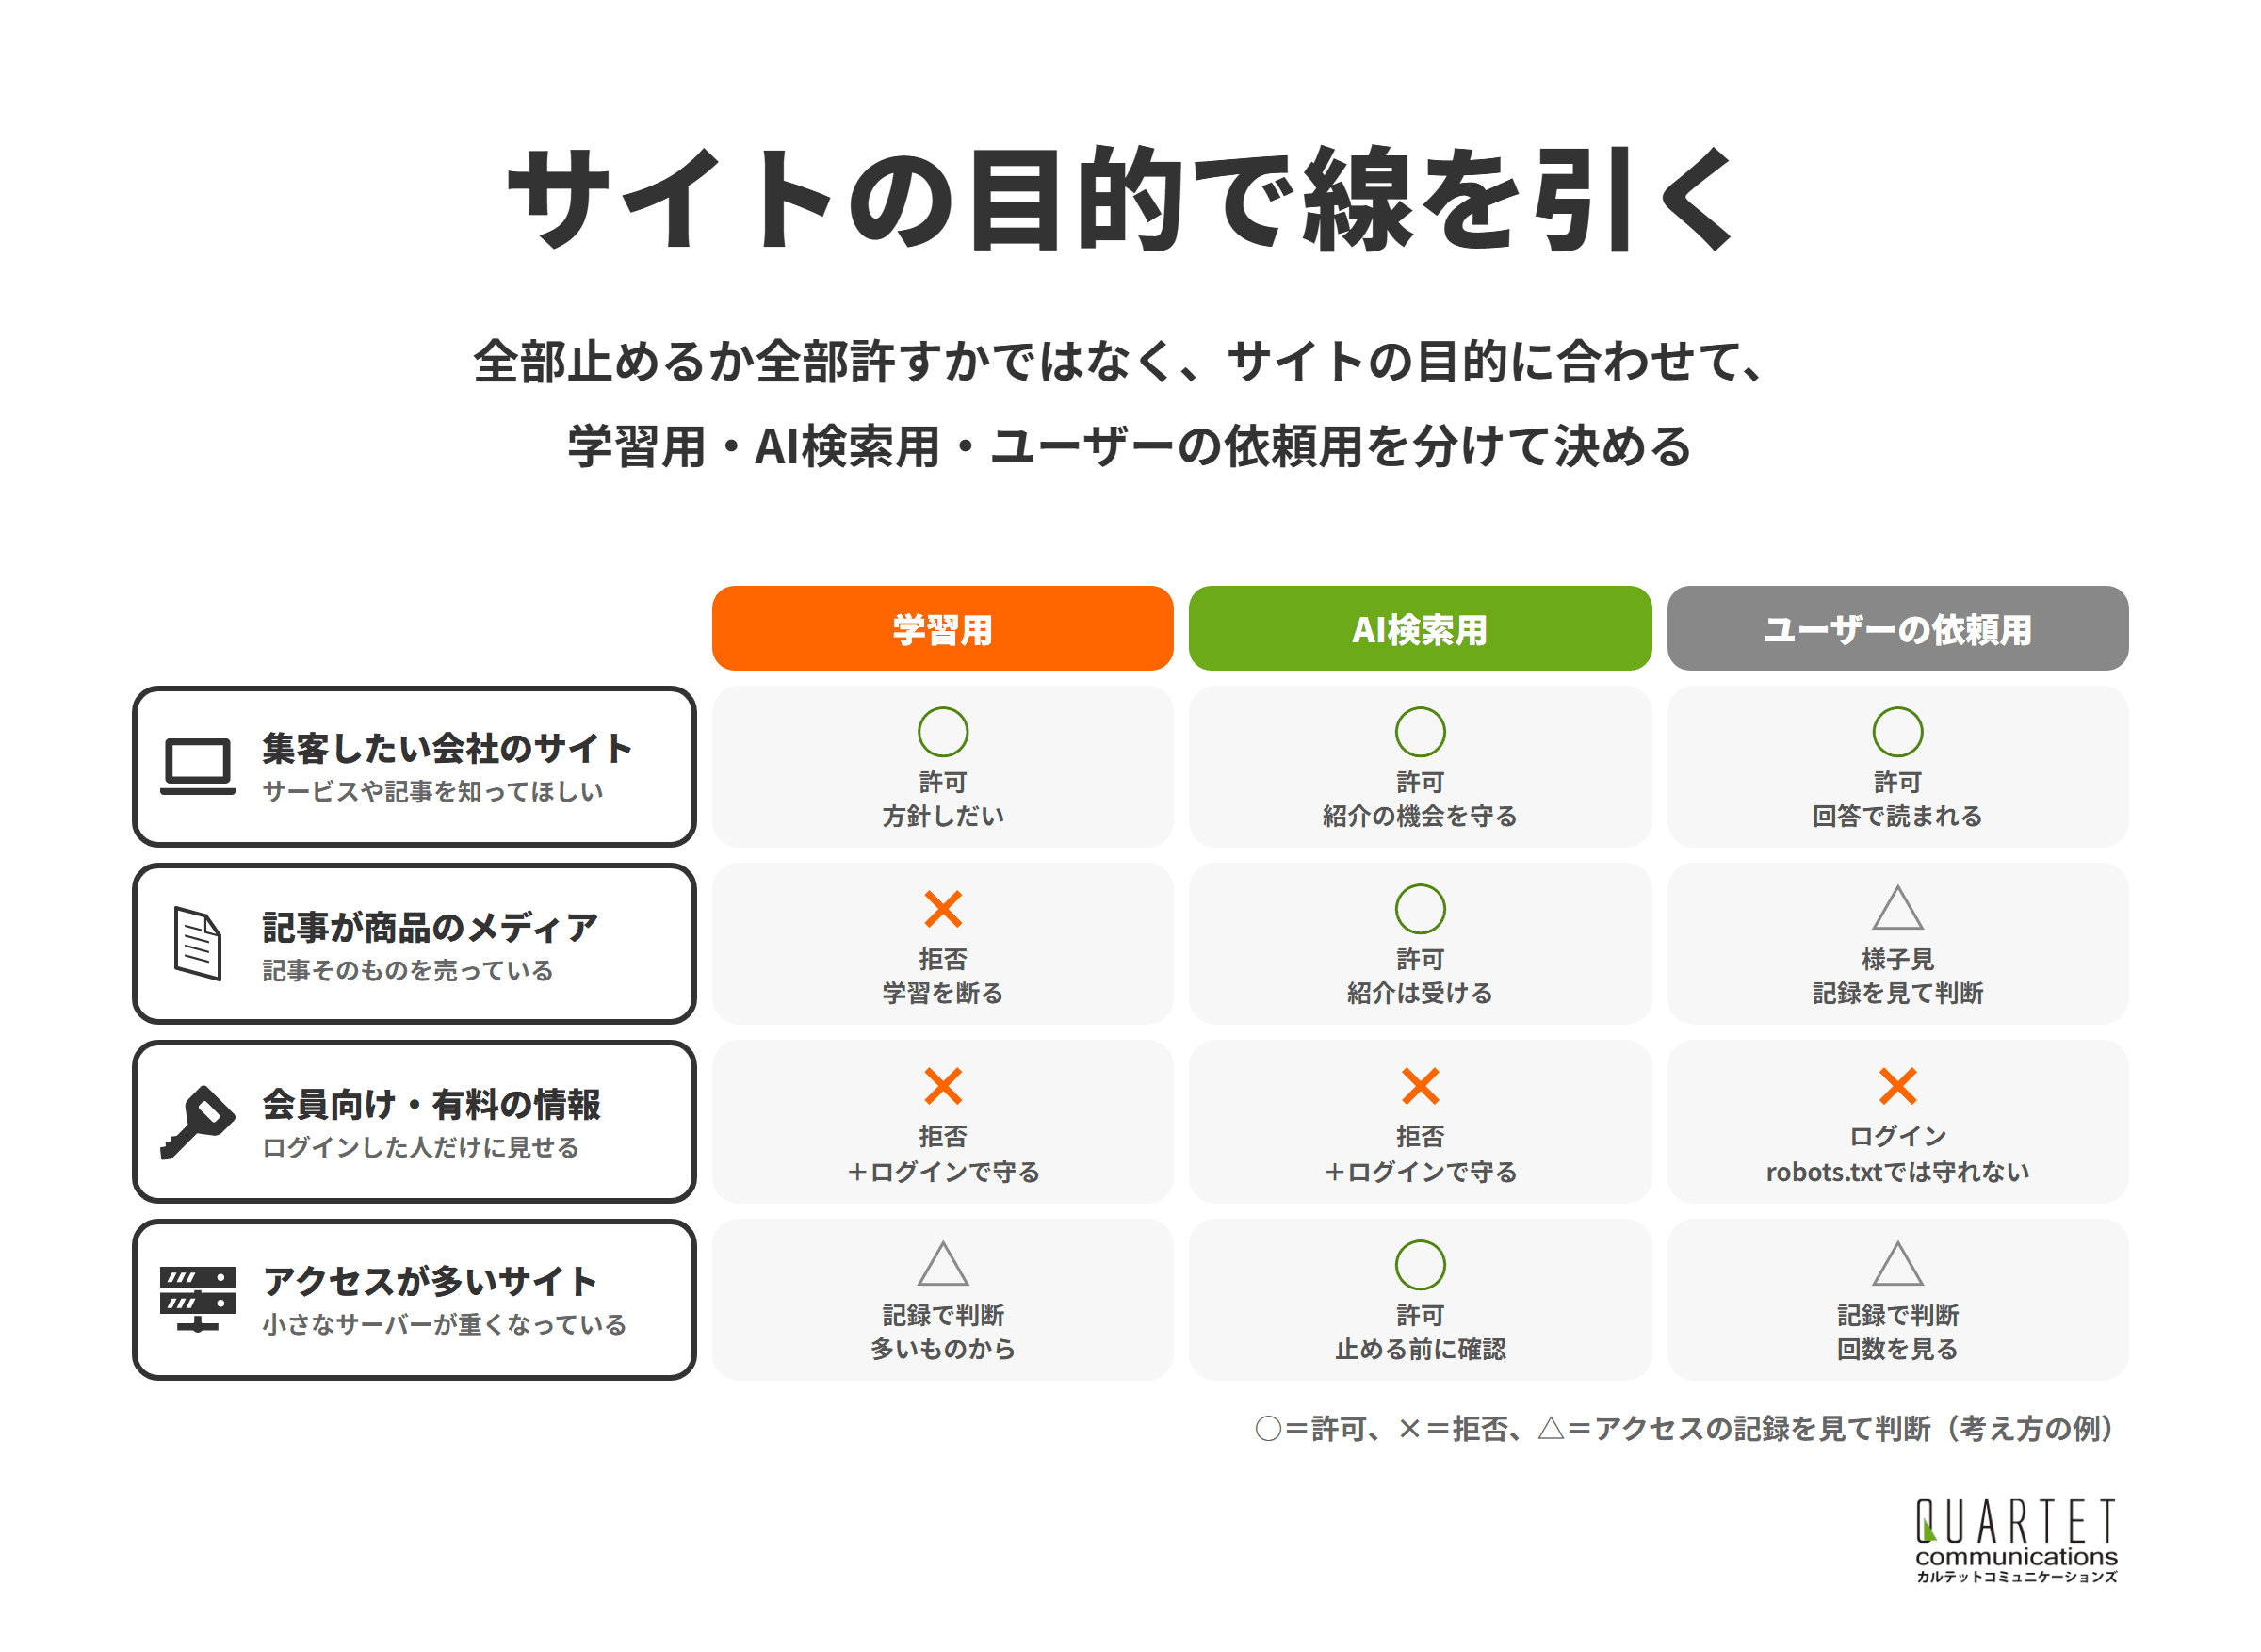
AIクローラーへの向き合い方に、どのサイトにも当てはまる正解はありません。
自社のサイトの目的と、守りたいものをはっきりさせてから線を引くと、設定に迷わなくなります。
考え方①|集客したいサイトは、AI検索用のクローラーを止めない
サービスや記事を知ってもらうためのサイトなら、AI検索の回答で紹介されることは、新しいお客さまとの接点になります。
Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers, though can still appear as navigational links.
引用元:OpenAI「Overview of OpenAI Crawlers」
(OAI-SearchBotをオプトアウトしたサイトは、ChatGPTの検索の回答には表示されません。ただし、ナビゲーションのリンクとしては表示されることがあります。)
集客を目的にしたサイトでAI検索用のクローラーまで止めてしまうと、せっかくの記事が回答で紹介される機会を失います。
AIの回答で紹介されるための考え方は、LLMO最適化とはでも解説しています。
集客したいサイトでは、AI検索用のクローラーを許可したままにしましょう。
考え方②|学習に使われたくないなら、学習用だけを止める
記事や写真を独自に作っていて、AIの学習に使われることを避けたい場合は、学習用のクローラーだけを止めます。
GPTBot、ClaudeBot、Google-Extended、Applebot-Extended、CCBotなどを拒否しても、AI検索用のクローラーを許可していれば、AI検索での紹介は続けられます。
記事そのものが商品のメディアでは、こうした線引きが現実的な選び方になります。
学習を断りたいときは、AI検索用まで巻き込まないように名前を分けて書きましょう。
考え方③|会員向けや有料の情報は、ログインで守る
会員だけに見せる記事や有料の資料などは、robots.txtで止めるだけでは守れません。
robots.txtは守ってもらう前提のルールであり、ユーザーの依頼で読みに来るアクセスには適用されない場合もあるためです。
見せたくない情報は、ログインやパスワードで閲覧を制限し、検索やAIからも見えない状態にしておきます。
本当に守りたい情報は、robots.txtではなくログインで守りましょう。
考え方④|サーバーが重いときは、まずアクセスの記録を見る
AIクローラーのアクセスが増えてサーバーが重くなった、という相談もあります。
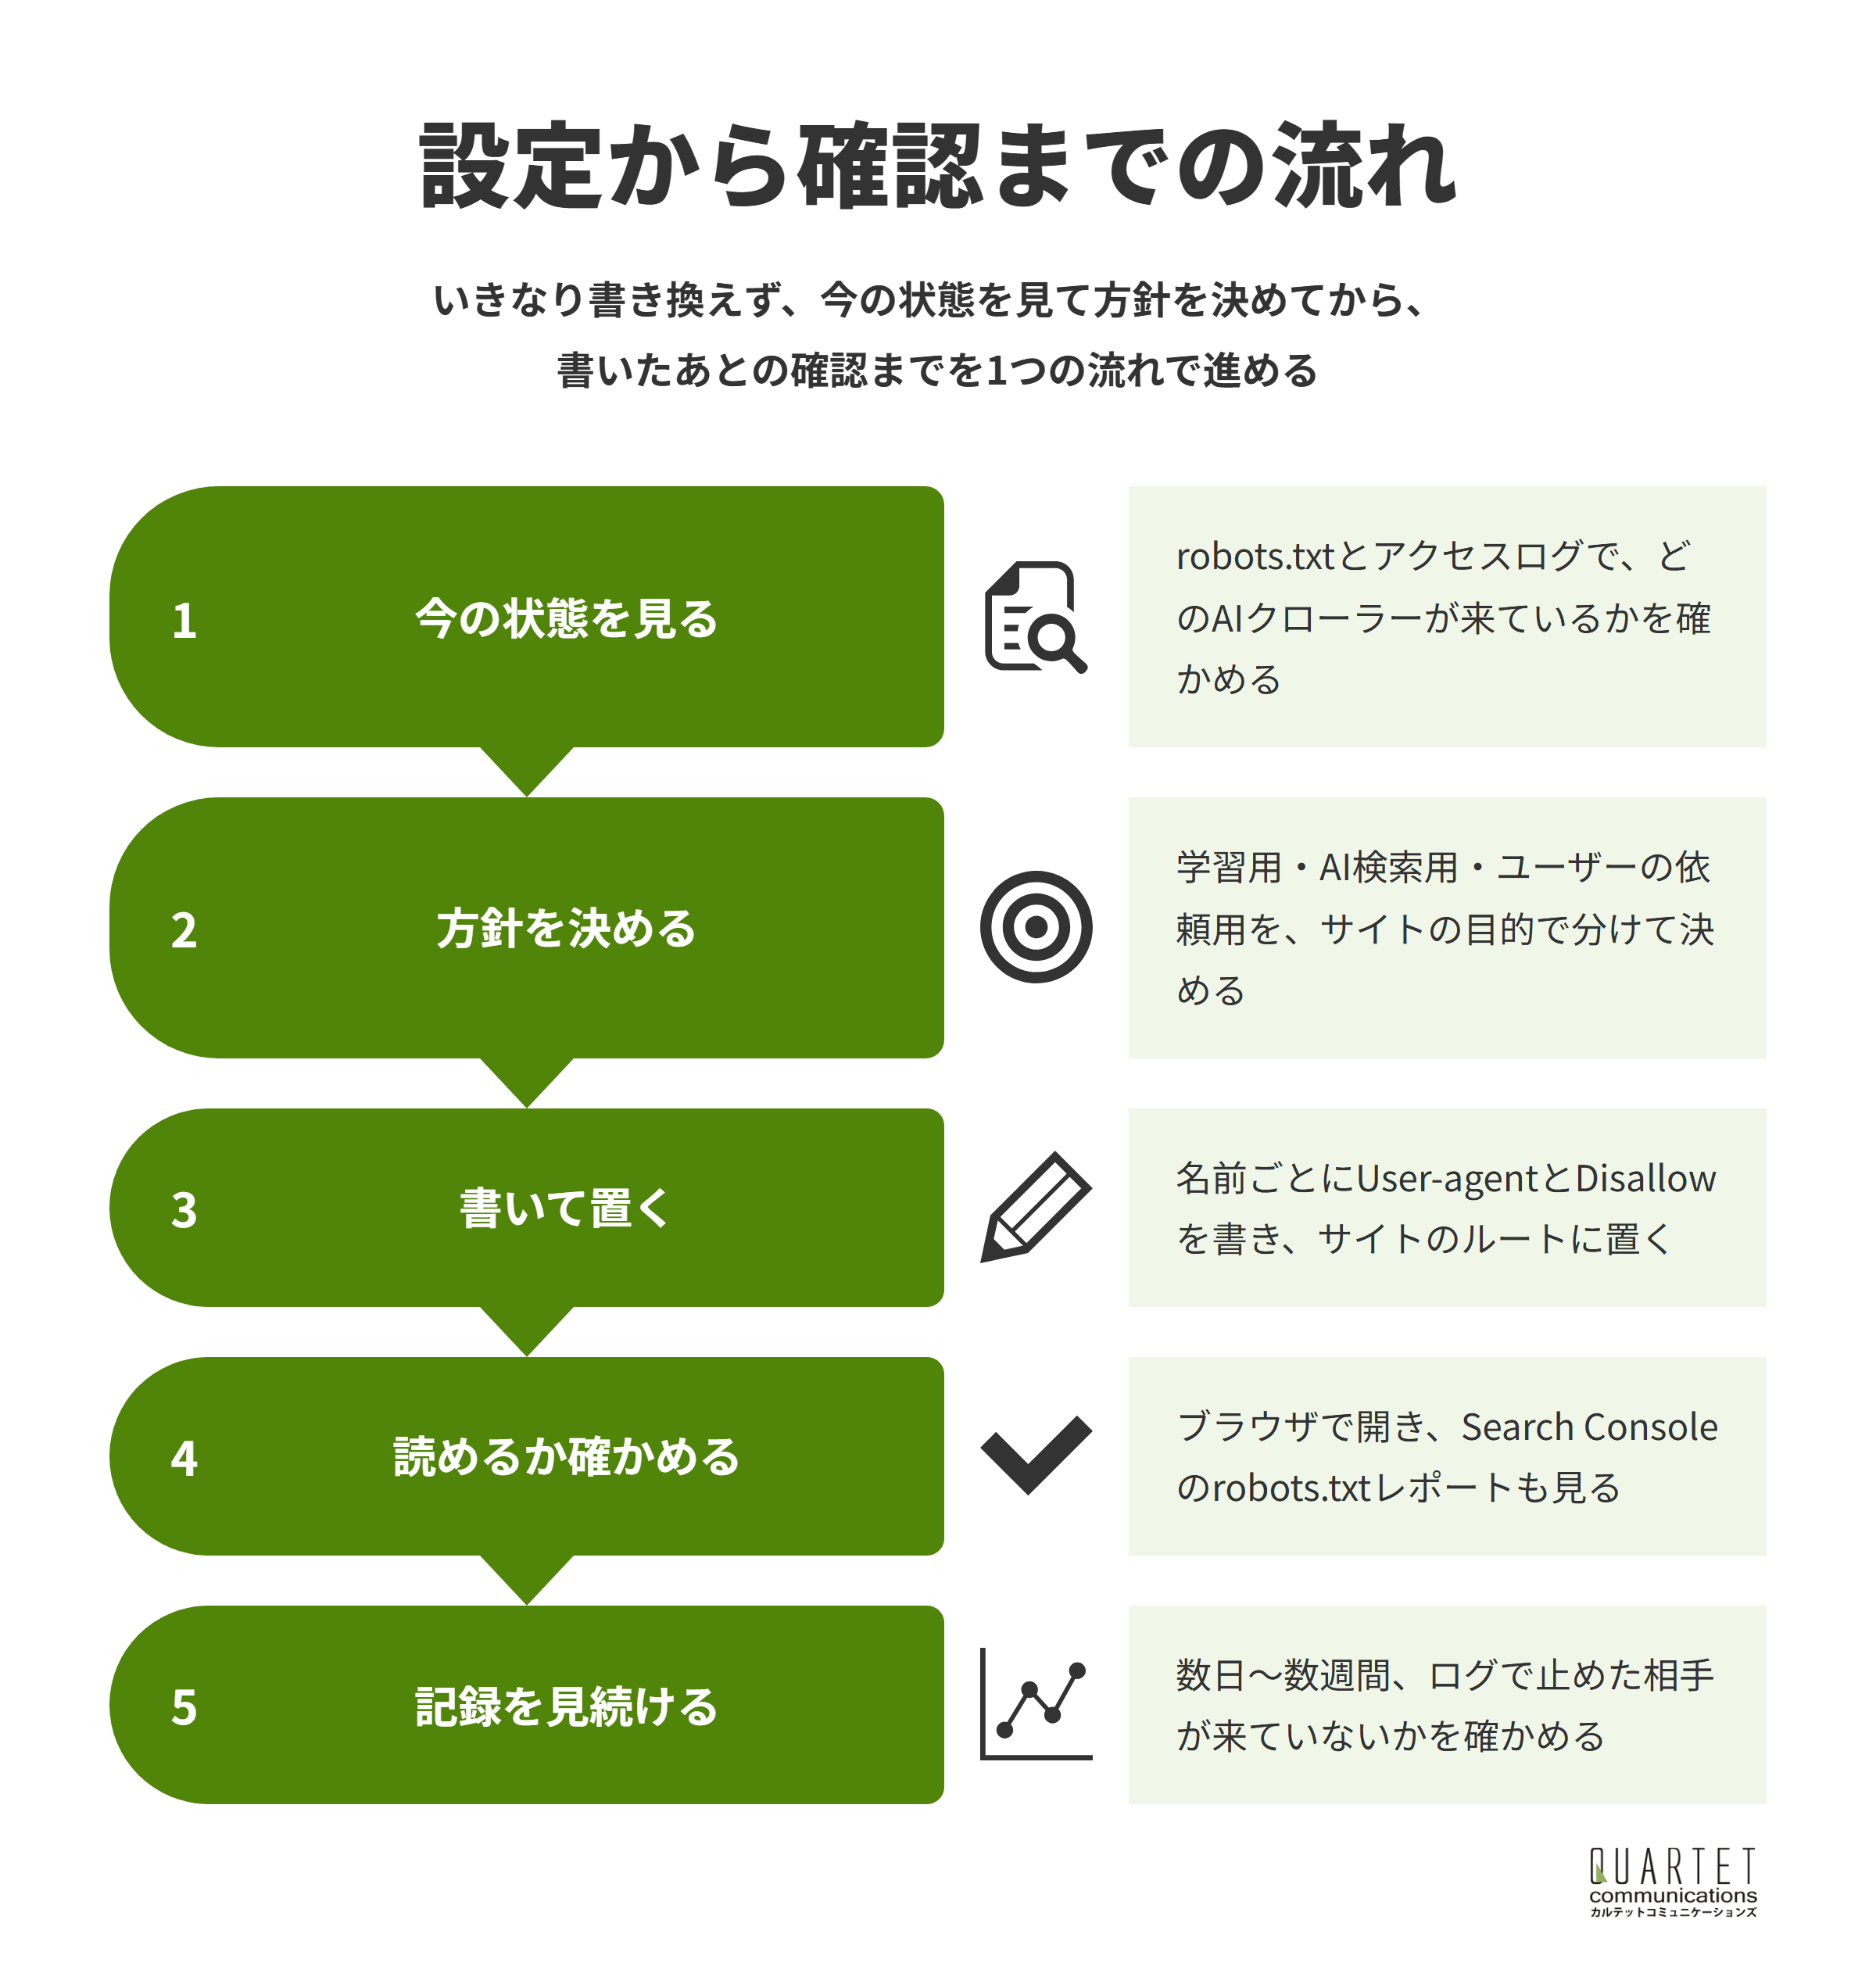
その場合は、いきなりすべてを止めるのではなく、アクセスの記録(ログ)で、どの名前のクローラーが、どのページに、どのくらい来ているかを先に確かめます。
Anthropicのように、robots.txtのCrawl-delay(読みに来る間隔)の指定に対応すると説明している会社もあるため、止める前に間隔の調整を試す方法もあります。
負荷の問題は、ログで相手と回数を確かめてから対策を決めましょう。
robots.txtでAIクローラーを遮断する設定の書き方
この章でわかること
- 書き方①|robots.txtの置き場所と、基本の書き方
- 書き方②|GPTBotだけを拒否する
- 書き方③|学習用のクローラーをまとめて拒否する
- 書き方④|一部のフォルダだけを拒否する
- 書き方⑤|すべてを拒否する書き方は慎重に
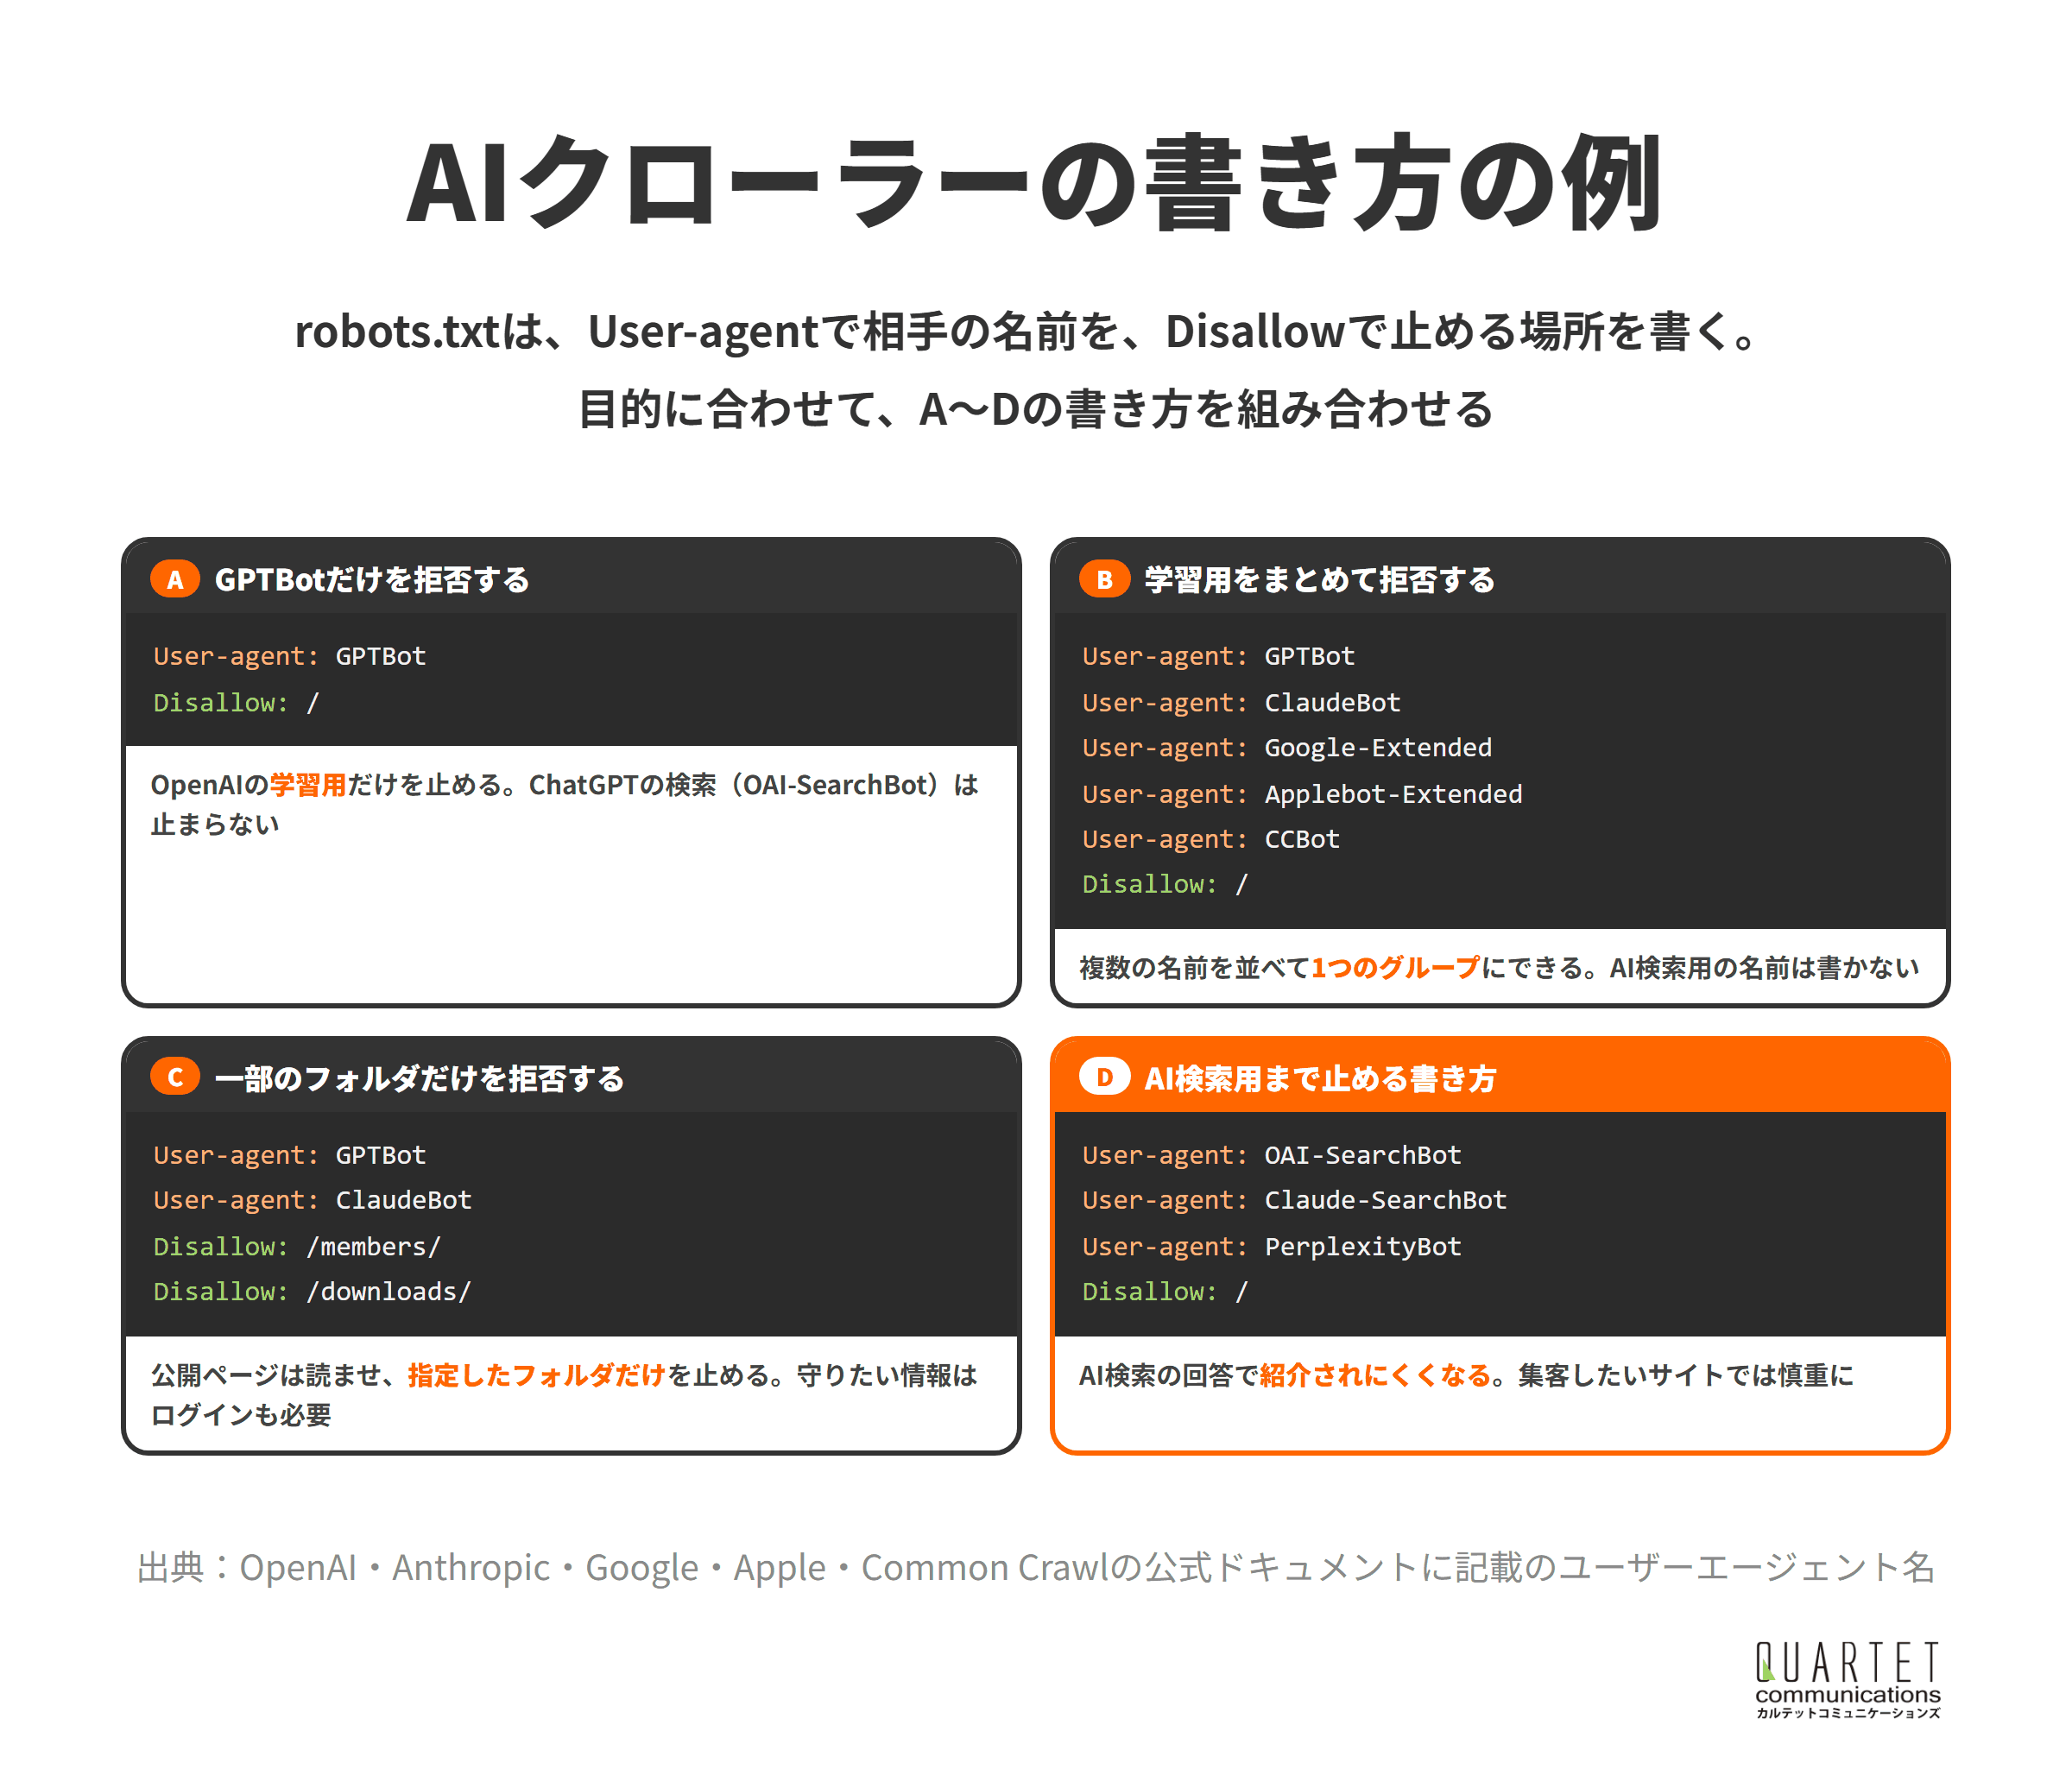
robots.txtの書き方そのものは難しくありませんが、1文字の間違いで意図しないクローラーまで止めてしまうことがあります。
ここでは、よく使う書き方の例を、目的ごとに紹介します。
書き方①|robots.txtの置き場所と、基本の書き方
robots.txtはサイトのルート(https://example.com/robots.txt)に置くテキストファイルで、サブドメインがある場合はサブドメインごとに用意します。
書き方は、User-agentの行で相手のクローラーの名前を、Disallowの行で読ませたくない場所を書くのが基本です。
# AIの学習用クローラーへの指定
User-agent: GPTBot
Disallow: /

# それ以外のクローラーはすべて許可
User-agent: *
Allow: /

Sitemap: https://example.com/sitemap.xml
「#」から始まる行はメモとして扱われ、設定には影響しません。
robots.txtはサイトのルートに置き、相手の名前と止める場所を1組ずつ書きましょう。
書き方②|GPTBotだけを拒否する
OpenAIの学習用のクローラーだけを止めたい場合は、User-agentにGPTBotを書き、Disallowにスラッシュ(/)を書きます。
User-agent: GPTBot
Disallow: /
この書き方ではChatGPTの検索用のOAI-SearchBotは止まらないため、ChatGPTの検索での紹介は続きます。
OpenAIの説明では、robots.txtを更新してから検索の結果に反映されるまで、24時間ほどかかることがあるとされています。
GPTBotだけを止めれば、学習を断りつつChatGPTの検索での紹介は続けられます。
書き方③|学習用のクローラーをまとめて拒否する
複数の会社の学習用クローラーをまとめて止めたいときは、User-agentの行を並べて、1つのグループにできます。
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /
AI検索用のOAI-SearchBot、Claude-SearchBot、PerplexityBotはこのグループに入れないため、AI検索での紹介は続けられます。
学習用をまとめて止めるときは、AI検索用の名前を入れていないかを見直しましょう。
書き方④|一部のフォルダだけを拒否する
サイト全体ではなく、特定のフォルダだけを学習に使われたくない場合は、Disallowにそのフォルダの場所を書きます。
User-agent: GPTBot
User-agent: ClaudeBot
Disallow: /members/
Disallow: /downloads/
ただし、会員向けのページなど本当に見せたくない情報は、robots.txtだけでなくログインで守る必要があります。
フォルダ単位で止めるときも、守りたい情報はログインとセットで考えましょう。
書き方⑤|すべてを拒否する書き方は慎重に
「User-agent: *」と「Disallow: /」を組み合わせると、AIクローラーだけでなく、Googlebotなど検索エンジンのクローラーまで止めてしまいます。
AI検索用のクローラーを名前で並べて止める書き方も、ChatGPTやPerplexityの回答で紹介されにくくなるため、集客したいサイトでは慎重に判断します。
書き換える前の内容を保存しておくと、意図しない結果になったときにすぐ元に戻せます。
すべてを止める書き方は、検索からの集客まで失うことを理解したうえで使いましょう。
カルテットのAIO(AI検索対策)コンサルティング
ChatGPT・Gemini・GoogleのAIによる概要で、自社が引用・推奨される状態をつくる支援です。今の見え方の診断から、コンテンツや会社情報・構造化データの整備、引用状況の計測までまとめて対応します。
AIクローラーの設定のあとに確かめる3つのこと
この章でわかること
- 確認①|ブラウザでrobots.txtを開き、中身を確かめる
- 確認②|Search Consoleのrobots.txtレポートで、Googleが読めているかを見る
- 確認③|アクセスログで、User-Agentと公開されたIPアドレスを照らし合わせる
robots.txtは書いて終わりではなく、相手に正しく読まれているか、意図した相手だけが止まっているかを確かめて初めて役に立ちます。
設定のあとは、次の3つを順に確かめます。
確認①|ブラウザでrobots.txtを開き、中身を確かめる
まず、ブラウザで「https://自社のドメイン/robots.txt」を開き、書いた内容がそのまま表示されるかを確かめます。
CMSやプラグインが自動でrobots.txtを作る仕組みもあるため、編集した内容が実際に表示されているかを目で見ておくことが大切です。
サブドメインを使っている場合は、サブドメインごとに同じように確かめます。
設定したら、まずブラウザでrobots.txtを開いて中身を目で確かめましょう。
確認②|Search Consoleのrobots.txtレポートで、Googleが読めているかを見る
Googleの検索に関わる部分は、Search Consoleのrobots.txtレポートで、Googleがrobots.txtを読めているか、エラーがないかを確かめられます。
AIクローラー向けに書き足したときに書き方を間違えると、Googlebot向けのルールまで崩れることがあるため、このレポートで問題がないかを見ておきます。
あわせて、Search ConsoleのURL検査で、主要なページがGooglebotにクロールできる状態かも確かめます。
AIクローラーの設定を変えたら、Search ConsoleでGooglebotへの影響も確かめましょう。
確認③|アクセスログで、User-Agentと公開されたIPアドレスを照らし合わせる
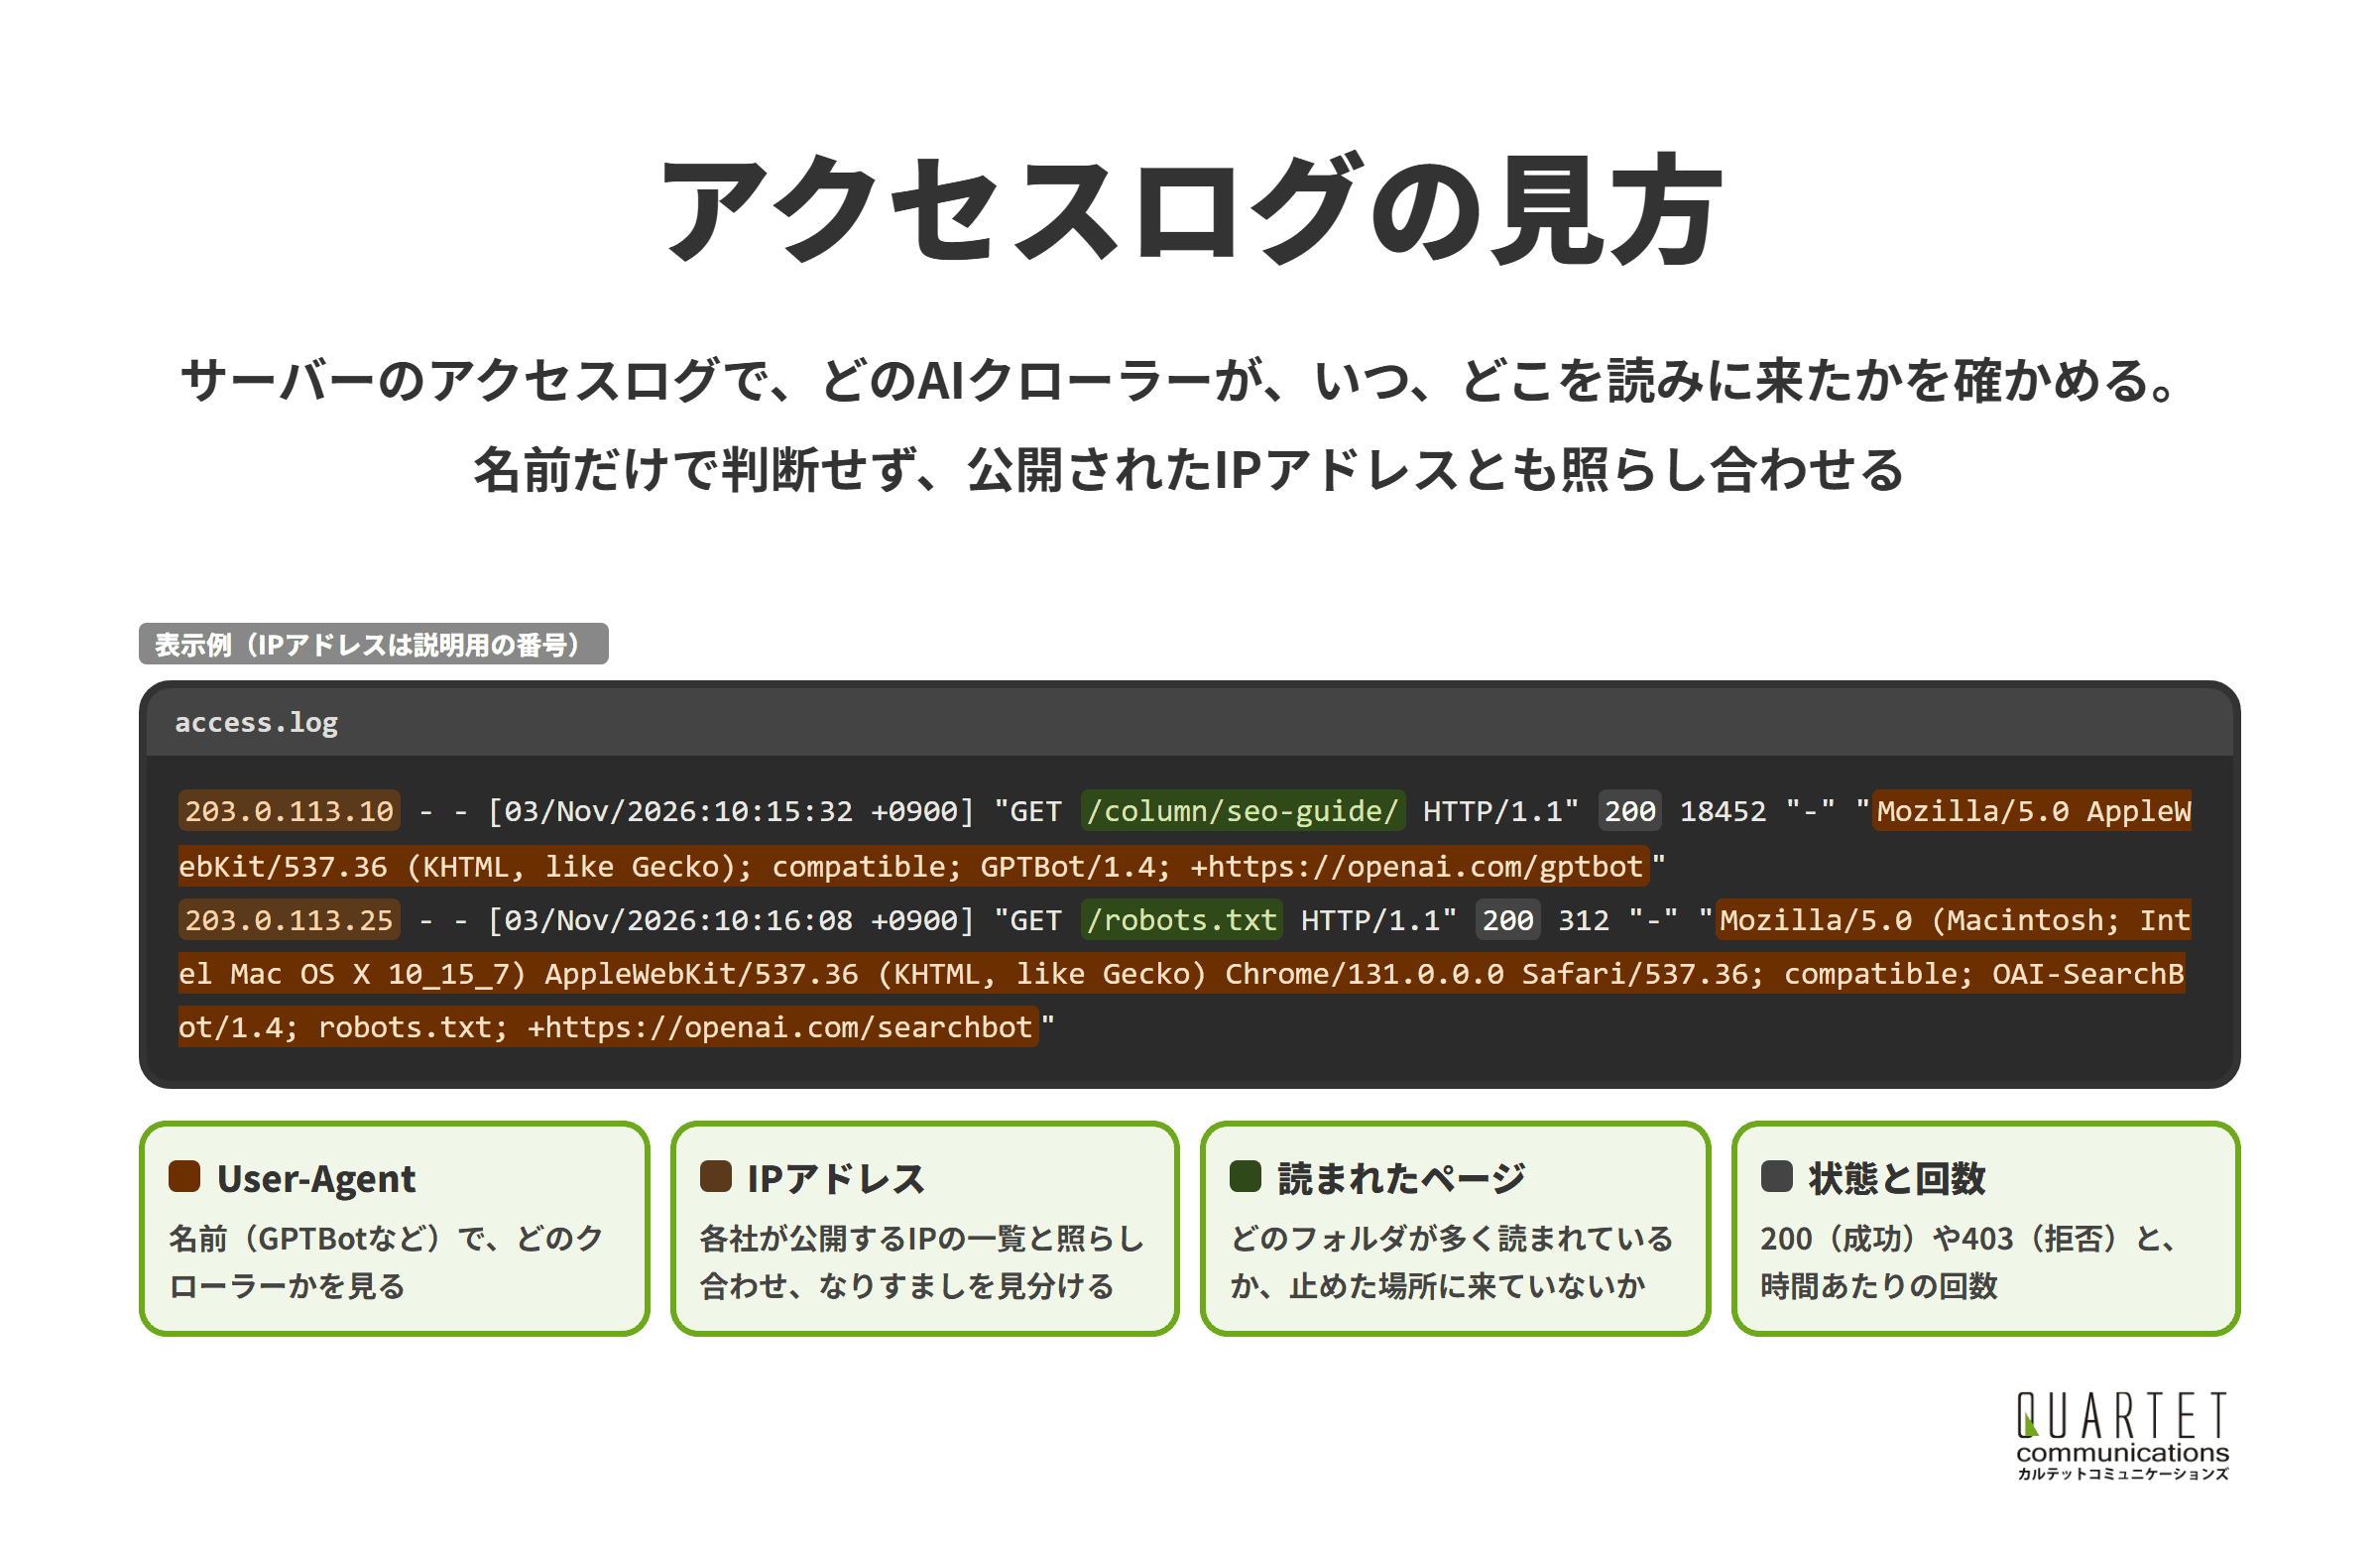
サーバーのアクセスログでは、どの名前(User-Agent)のクローラーが、いつ、どのページを読みに来たかが分かります。
OpenAIやAnthropic、Perplexityはクローラーが使うIPアドレスを公開しているため、名前とIPアドレスを照らし合わせると、名前だけを名乗るなりすましを見分けられます。
設定のあと数日から数週間は、止めたはずの名前のアクセスが続いていないかを見ておきます。
ログでは名前とIPアドレスの両方を見て、本物のクローラーかを確かめましょう。
AIクローラーについてよくある誤解
この章でわかること
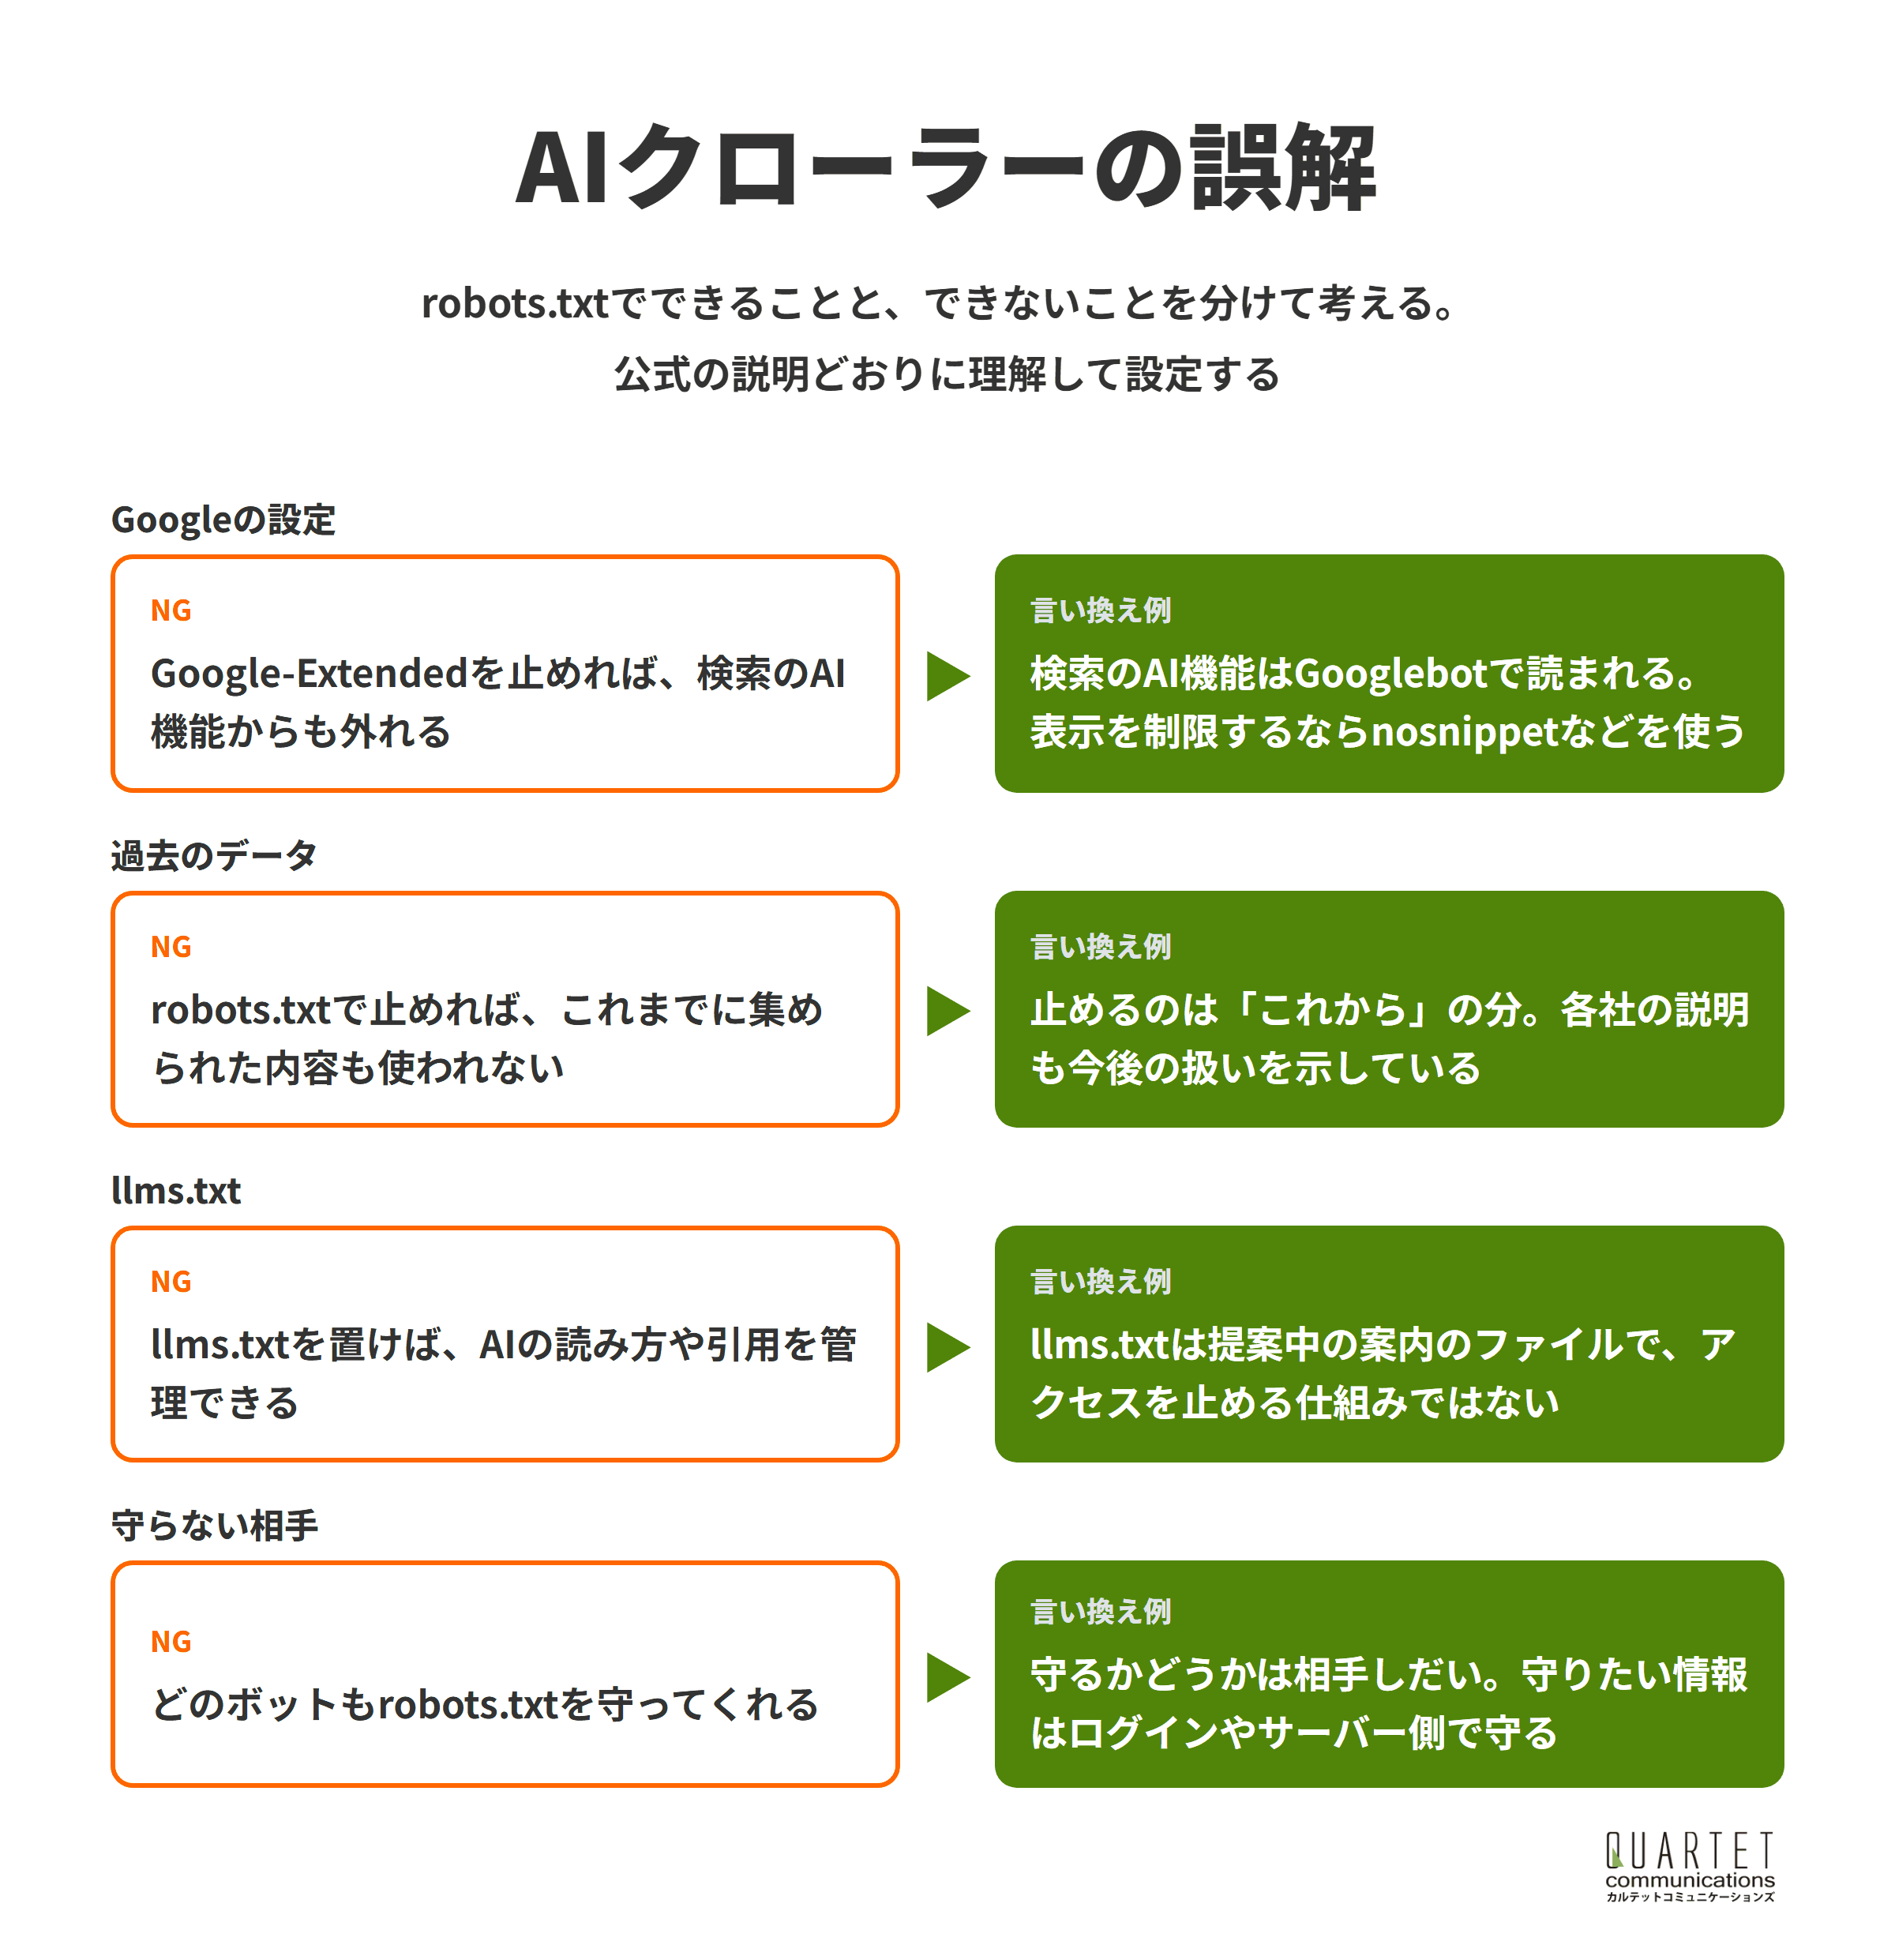
- 誤解①|Googleの学習用の設定で、検索のAI機能からも外れる
- 誤解②|止めれば、これまでに集められた内容も使われなくなる
- 誤解③|llms.txtを置けば、AIの読み方を管理できる
- 誤解④|どのボットもrobots.txtを守ってくれる
AIクローラーはまだ新しい話題のため、思い込みのまま設定してしまう例も見られます。
ここでは、よくある誤解と、公式の説明に基づく正しい理解を整理します。
誤解①|Googleの学習用の設定で、検索のAI機能からも外れる
Google-Extendedを止めれば、Google検索のAIによる概要(AI Overviews)にも載らなくなる、と考える人がいます。
しかし、Googleの検索のAI機能は検索に組み込まれており、検索のためのクロールはGooglebotが行います。
検索に表示されるページからの情報を制限するには、nosnippet、data-nosnippet、max-snippet、noindex コントロールを使用します。
引用元:Google検索セントラル「AI 機能とウェブサイト」
つまり、検索のAI機能での表示を制限したいときは、Google-Extendedではなく、ページ側のスニペットの設定やnoindexを使います。
noindexの使い方はnoindexとnofollow、AIによる概要への対策はAIO最適化(AI Overview)で解説しています。
検索のAI機能での表示は、Google-Extendedではなく、ページ側の設定で管理しましょう。
誤解②|止めれば、これまでに集められた内容も使われなくなる
robots.txtで学習用のクローラーを止めると、これまでに集められた内容まで消える、と思われがちです。
各社の説明は拒否したあとの「これから」の扱いを示すもので、Anthropicの説明でも「今後の資料」を学習データから除外するよう示すと書かれています。
すでに集められた内容の扱いを知りたいときは、各社の公式の窓口やヘルプを確かめます。
robots.txtの拒否は、これから先の扱いを伝えるものと理解しておきましょう。
誤解③|llms.txtを置けば、AIの読み方を管理できる
llms.txtは、AIにサイトの概要や読んでほしいページを伝えるための案内のファイルとして提案されているものです。
アクセスを止めたり許したりする仕組みではなく、AIの会社が読むことを約束しているものでもないため、効果は確かめられていません。
AIクローラーの許可や拒否は、llms.txtではなくrobots.txtで設定します。
llms.txtはアクセスの管理には使えないと理解し、設定はrobots.txtで行いましょう。
誤解④|どのボットもrobots.txtを守ってくれる
大手の会社のクローラーはrobots.txtに従うと公式に説明していますが、すべてのボットが守るわけではありません。
ユーザーの依頼で読みに来るアクセスには適用されない場合があることを各社が説明しているほか、名前を偽るアクセスもあります。
守らない相手には、サーバーやCDNのボット対策の機能で制限する、ログインで守るなど、robots.txt以外の方法を組み合わせます。
robots.txtを守らない相手には、サーバー側やログインでの対策を組み合わせましょう。
カルテットのAIO(AI検索対策)コンサルティング
ChatGPT・Gemini・GoogleのAIによる概要で、自社が引用・推奨される状態をつくる支援です。今の見え方の診断から、コンテンツや会社情報・構造化データの整備、引用状況の計測までまとめて対応します。
AIクローラーについてよく聞かれる質問
この章でわかること
- 質問①|AIクローラーを拒否すると、Googleの検索順位は下がる?
- 質問②|ChatGPTの回答で自社のサイトを紹介してもらうには?
- 質問③|設定はどのくらいで反映される?
- 質問④|WAFやCDNを使っているときの注意は?
最後に、AIクローラーの設定について、よくいただく質問に答えます。
設定の進め方は、上の図の流れのとおり、今の状態を見ることから始めてください。
質問①|AIクローラーを拒否すると、Googleの検索順位は下がる?
GPTBotやClaudeBotなど、Google以外の会社のAIクローラーを拒否しても、Googleの検索順位には関係しません。
Google-Extendedも、Googleの説明では、検索への登録や順位の判断には使われないとされています。
ただし、書き間違いでGooglebotまで止めてしまうと検索に影響するため、設定のあとにSearch Consoleで確かめておきます。
AIクローラーの拒否は順位に影響しませんが、Googlebotを巻き込まないよう注意しましょう。
質問②|ChatGPTの回答で自社のサイトを紹介してもらうには?
まず、OAI-SearchBotを止めていないかをrobots.txtで確かめ、OpenAIが公開しているIPアドレスからのアクセスをサーバーやCDNで止めていないかも確かめます。
そのうえで、AIの回答で取り上げられやすいように、疑問にはっきり答える文章や、事実と出典が分かるページを整えることが大切です。
AIの回答での紹介のされ方を整えたい方は、カルテットコミュニケーションズのAIO・LLMOコンサルティングでもご相談いただけます。
AI検索で紹介されるには、まずクローラーが読める状態を確かめ、そのうえで中身を整えましょう。
質問③|設定はどのくらいで反映される?
反映までの時間は会社によって違い、OpenAIは、robots.txtを更新してから検索の結果に反映されるまで24時間ほどかかることがあると説明しています。
ほかの会社のクローラーも、robots.txtを読み直すまでは前の設定のまま動くため、すぐに結果を判断しないようにします。
設定のあとは、数日から数週間、アクセスログで止めた相手のアクセスが減っているかを見ていきます。
設定の効果は、数日から数週間かけてアクセスログで確かめましょう。
質問④|WAFやCDNを使っているときの注意は?
WAFやCDNのボット対策の機能を使っていると、robots.txtで許可しているAIクローラーまで、サーバーの手前で止められていることがあります。
GoogleもAI機能についての説明で、robots.txtに加えて、CDNやホスティングの設定でクロールが許可されていることを確かめるよう勧めています。
Perplexityも、WAFを使っている場合は自社のボットを明示的に許可する必要があることがあるとして、設定の案内を公開しています。
WAFやCDNの設定も、robots.txtと同じ方針になっているかを確かめましょう。
まとめ|AIクローラーは、学習と引用を分けて決めたサイトが得をする
この記事の要点
- AIクローラーの目的は学習・AI検索・ユーザーの依頼の3つで、名前が分かれている
- 学習を断りたいなら学習用だけを止め、AI検索用は集客のために残す
- robots.txtは守ってもらう前提のルールで、守りたい情報はログインで守る
- 検索のAI機能での表示は、Google-Extendedではなくnosnippetなどで管理する
- 設定のあとはブラウザ・Search Console・アクセスログで確かめる
AIクローラーへの対応は、すべてを止めるか許すかの二択ではなく、学習とAI検索での紹介を分けて考えることで、集客と権利の両方を守れます。
AI検索の利用が広がるなかで、どのクローラーに読ませ、どこで紹介されたいかを決めておくことは、これからのWeb集客の土台になります。
設定の方針に迷ったら、カルテットコミュニケーションズのAIO・LLMOコンサルティングの無料相談をご利用ください。
今のrobots.txtとアクセスの状況を拝見し、AI検索での見え方も含めて、設定の方針を一緒に考えます。
カルテットのAIO(AI検索対策)コンサルティング
ChatGPT・Gemini・GoogleのAIによる概要で、自社が引用・推奨される状態をつくる支援です。今の見え方の診断から、コンテンツや会社情報・構造化データの整備、引用状況の計測までまとめて対応します。